Prometheus 三件套:怎么查?
对应短视频主题:Prometheus 三件套:怎么查?
资料核验与更新:2026-09-12
网站变慢时,最容易陷入的误区是直接猜原因:是不是数据库慢了、是不是某个服务报错、是不是流量突然变大。更可靠的顺序是先用指标确认异常的范围和形状,再用日志补足发生了什么,最后用链路追踪定位一次请求具体慢在哪里。Prometheus、Grafana、Loki 这套组合常被称作 PLG Stack;本篇把它们放进一条可以执行的排障路径中理解。
阅读边界
本文依据原始课程的研究笔记、课程结构和发布文案整理。涉及产品、模型、版本、平台规则、价格或资格等可能变化的信息,实践前应以当前官方资料和实际环境为准。
先分清:三种信息分别回答什么
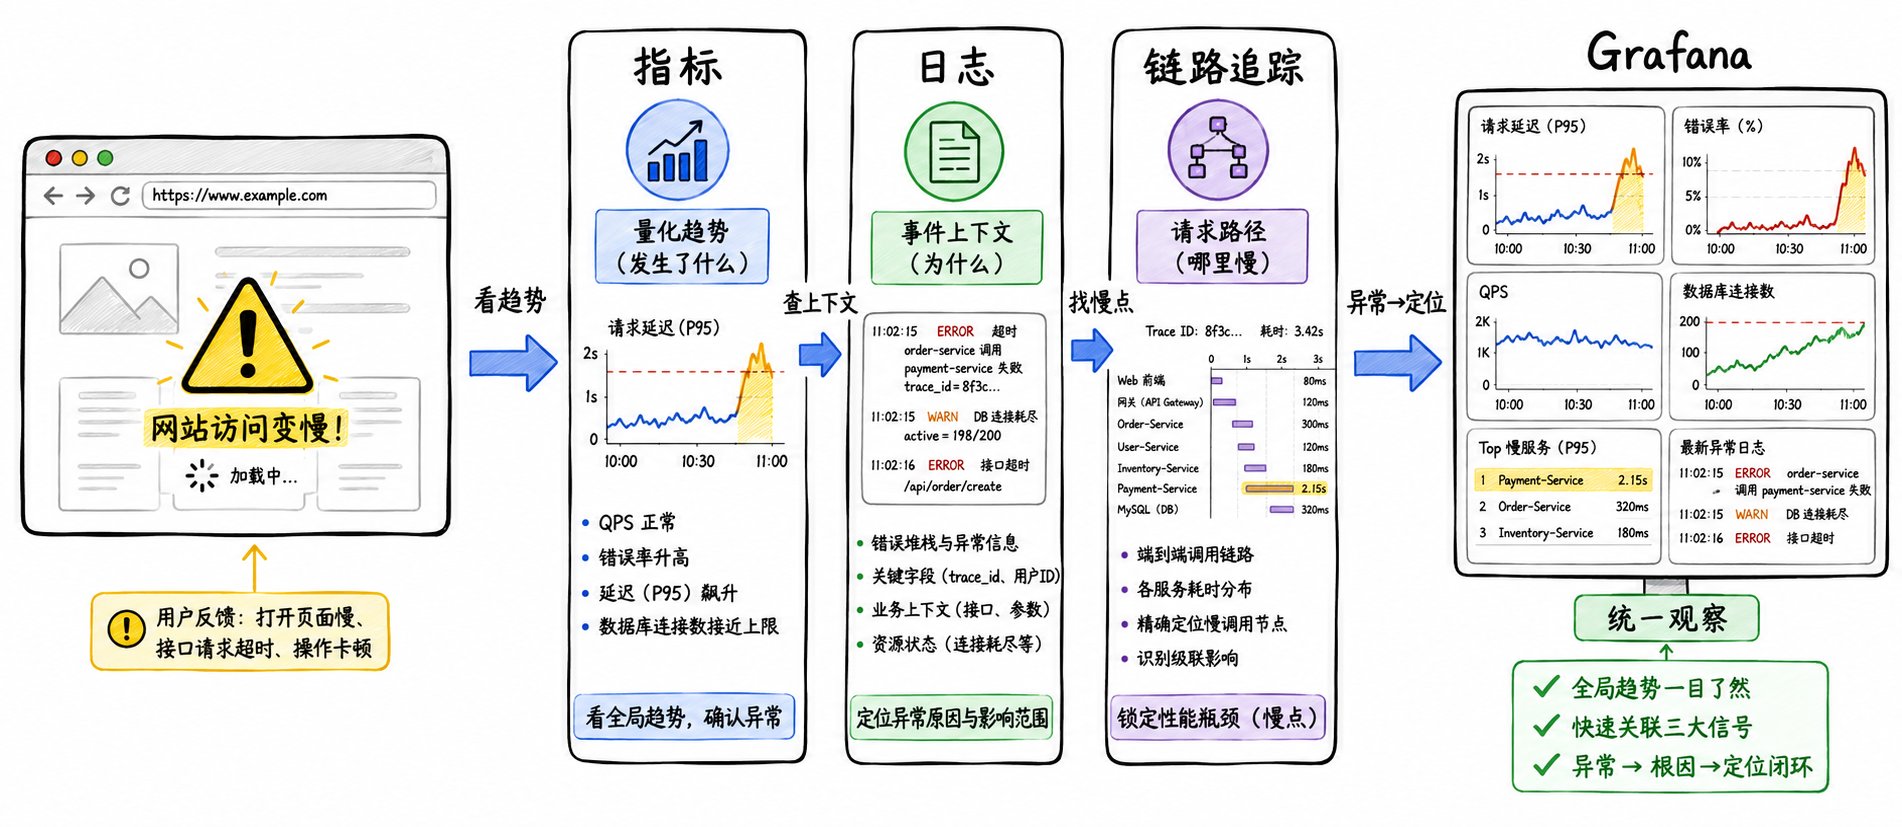
网站出现延迟或错误时,指标、日志和链路追踪从不同角度描述同一个系统。
可观测性不是“安装几个监控产品”。它的目标是让团队能从系统输出推断内部状态:现在是否异常、异常时发生了什么、以及一条请求究竟在哪一段变慢。Grafana 负责把多个数据源放到同一个查询与告警界面;它不是取代各个后端的存储系统。
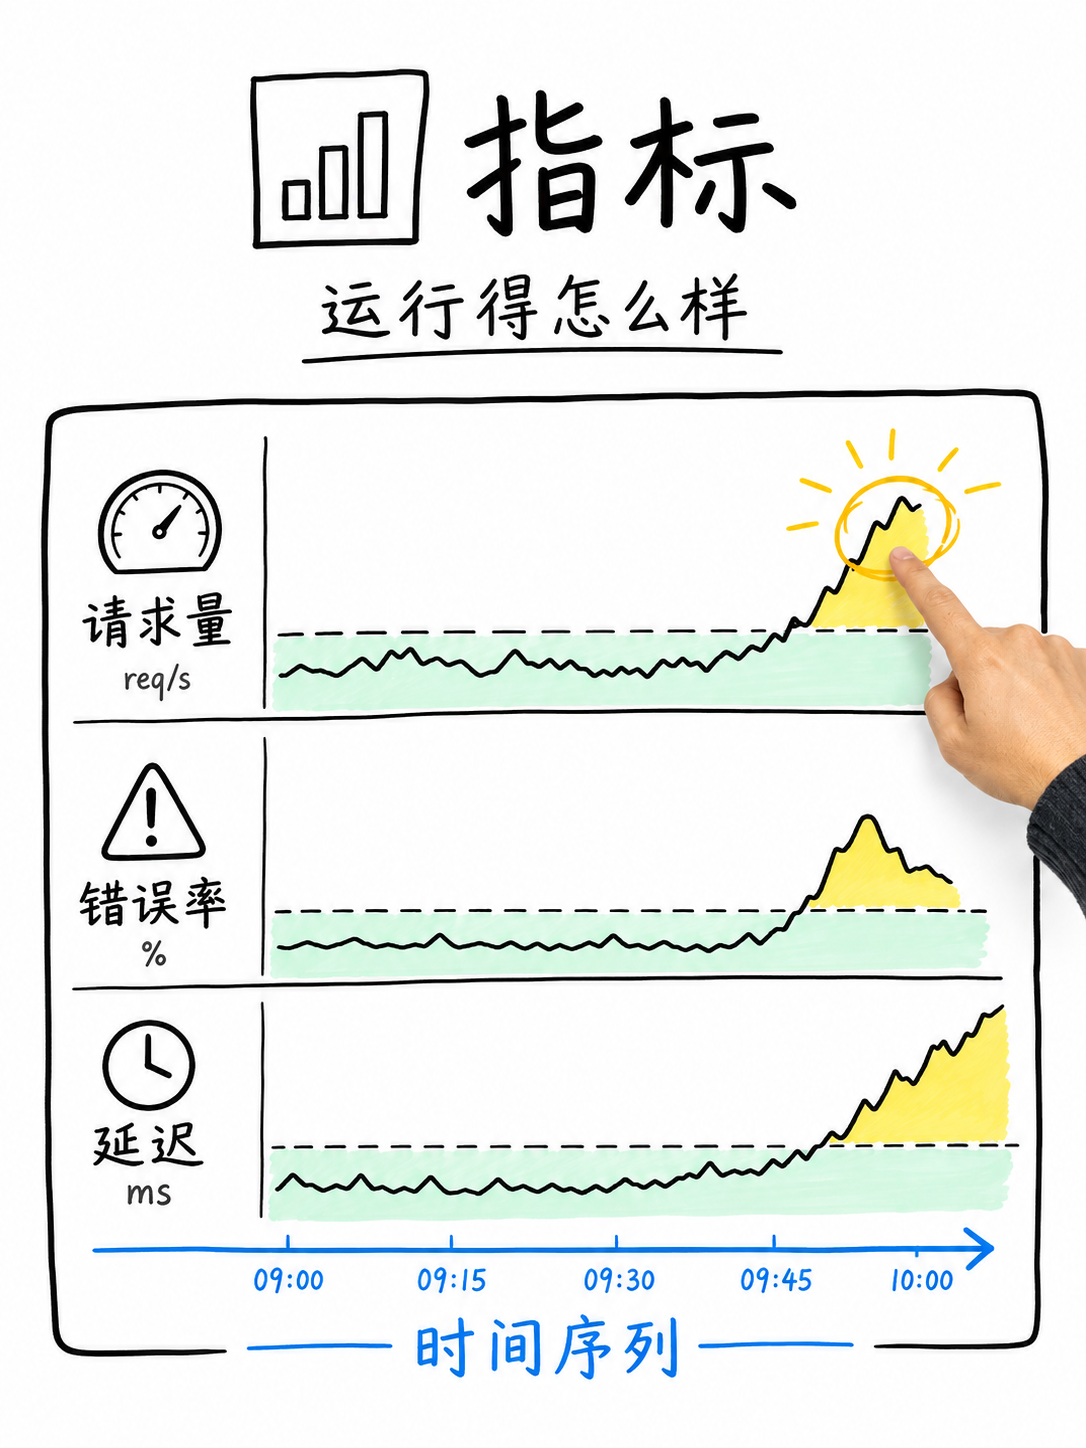
指标用于判断系统运行得怎么样,以及异常何时开始、影响范围多大。
可以把指标理解成系统的体温和心跳:请求量、错误率、响应时间、CPU、内存等数值持续带着时间被记录。它很适合回答“是否异常”和“异常从什么时候开始”,但通常不能直接解释某一条错误为何发生。
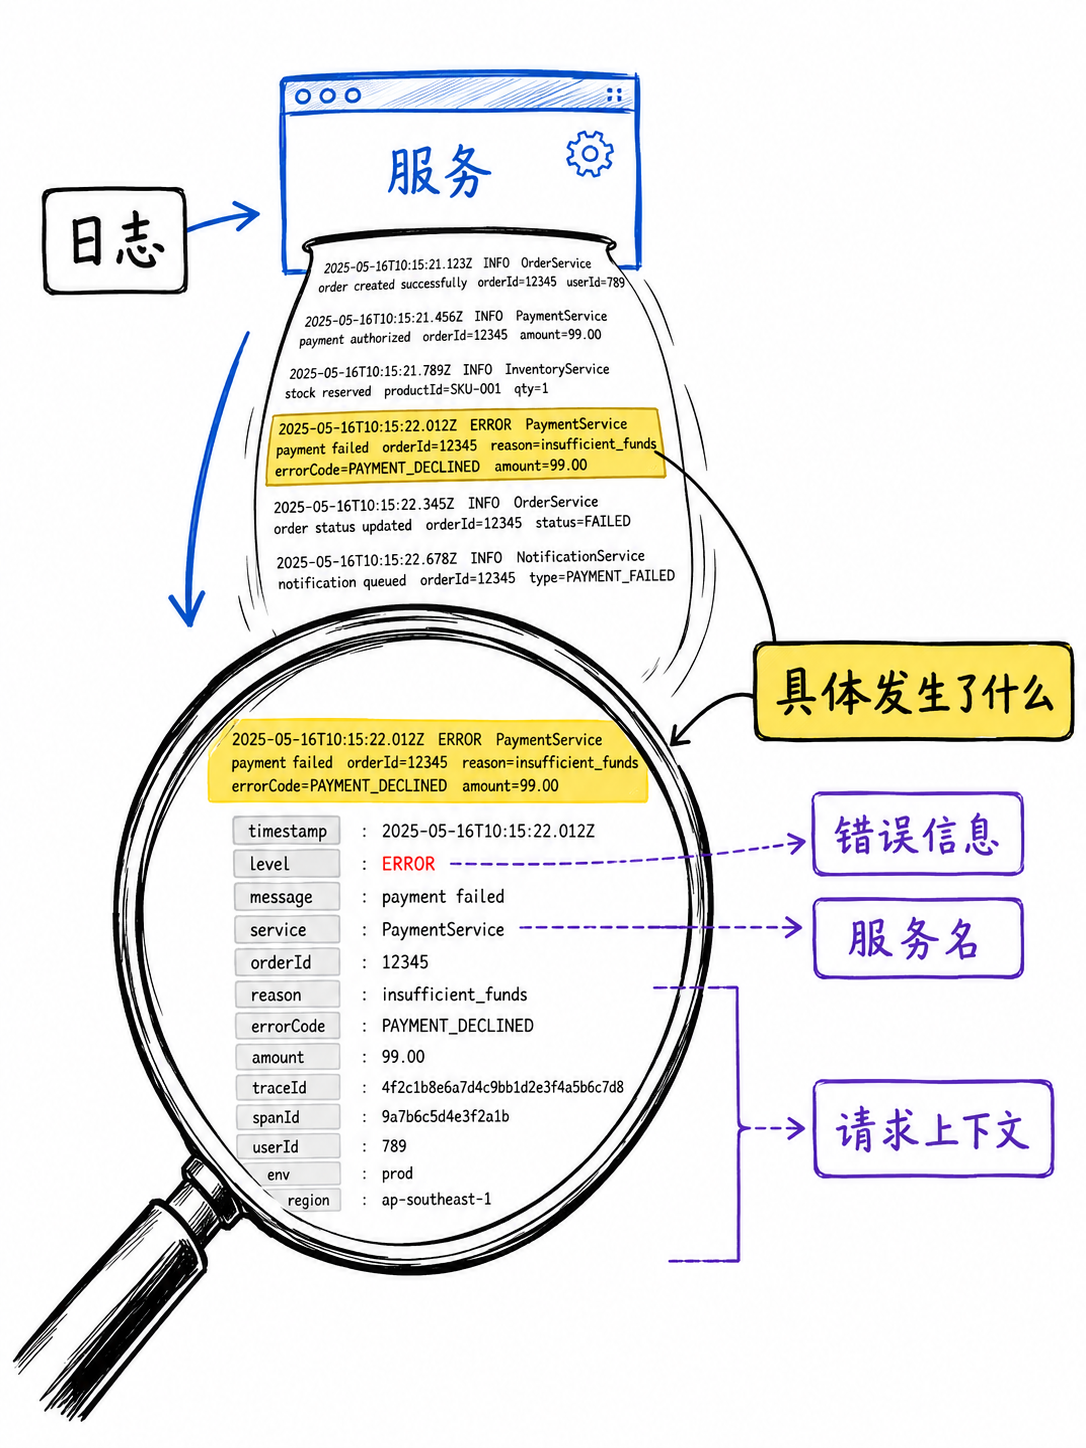
日志补充了指标中没有的事件细节和业务上下文。
日志更像问诊记录。它可以显示哪个操作出错、哪个服务参与、当时的错误信息和上下文。日志能够解释“发生了什么”,但单靠多份日志不一定能还原跨服务请求的完整因果链。
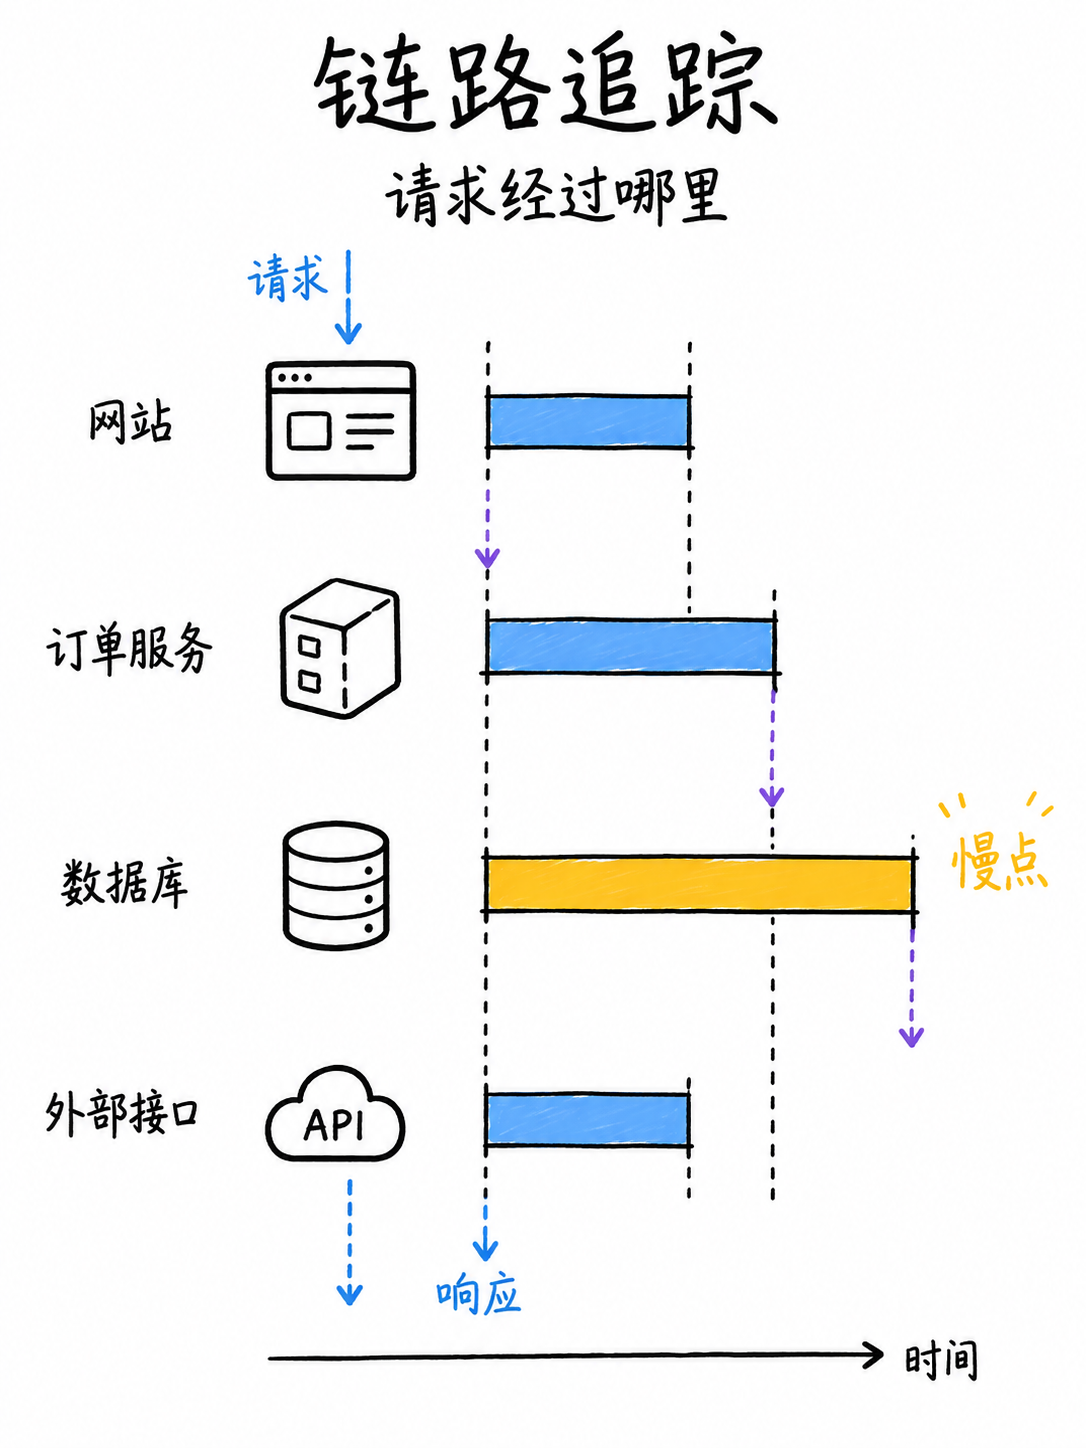
链路追踪把一次请求经过的服务和每一段耗时串成路径。
链路追踪适合回答“这次请求走过哪里、究竟慢在哪一段”。它依赖应用埋点或自动插桩,以及服务之间正确传播上下文;如果中间缺失记录,就不能把它误解为绝对完整的调用历史。
Prometheus 和 Grafana:先把趋势看清楚
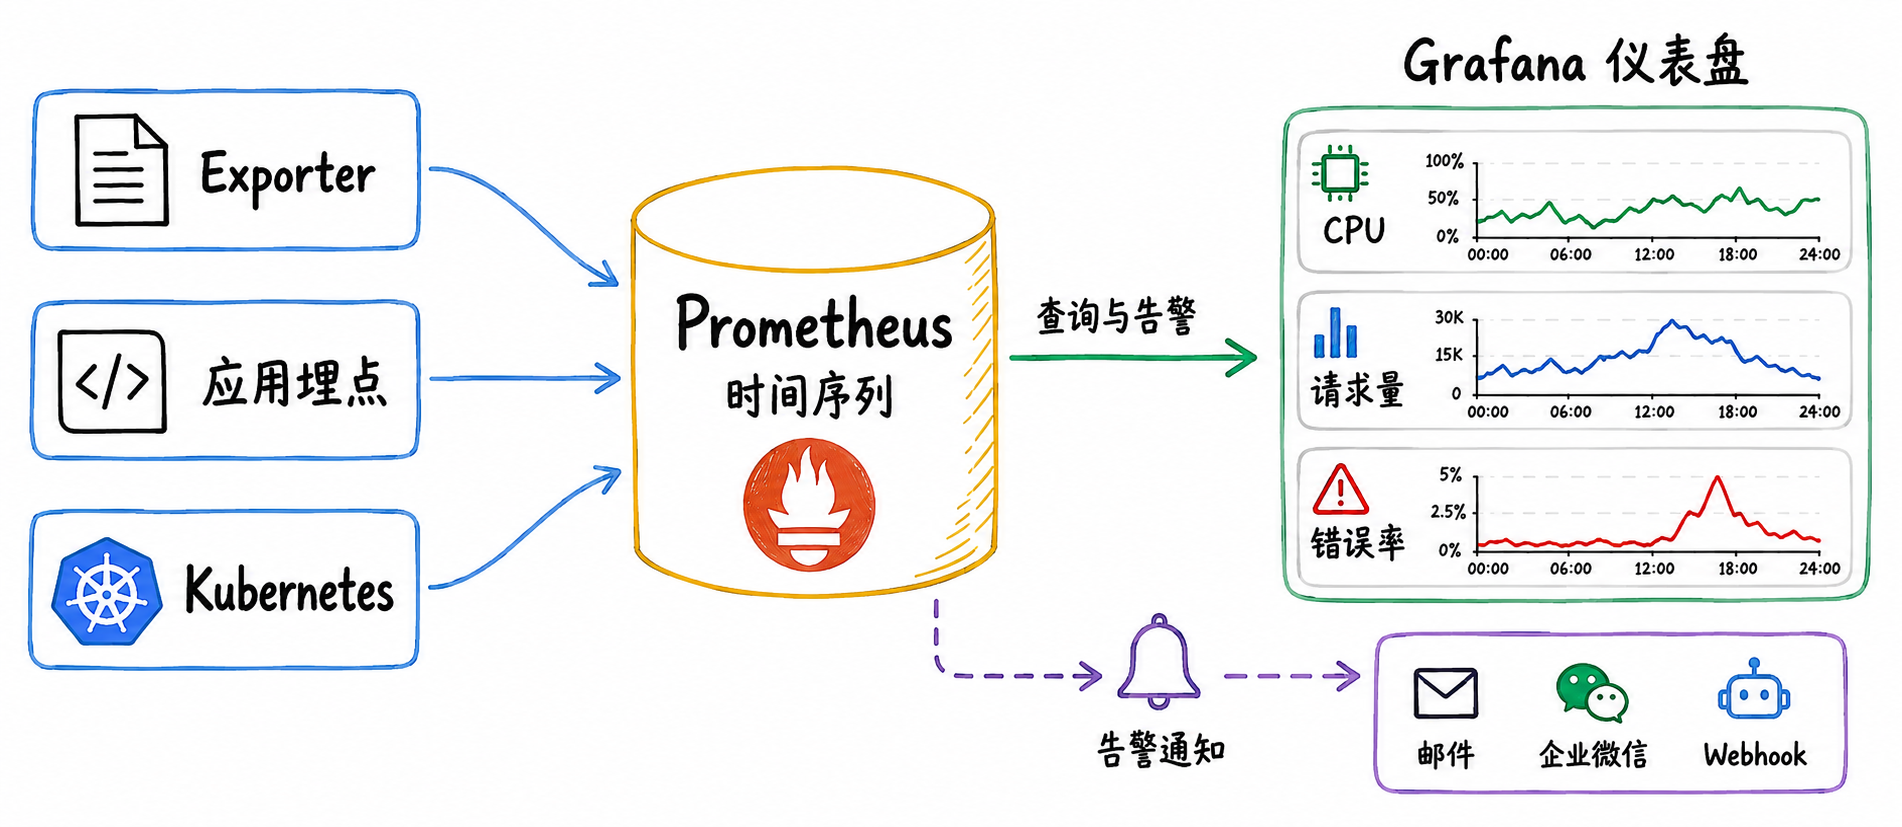
指标从应用、机器和 Kubernetes 等来源被采集,经过 Prometheus 保存和查询,再进入 Grafana。
Prometheus 会采集并存储带时间戳和标签的时间序列。机器状态通常由指标采集器暴露,应用埋点则补充请求量、错误率、延迟和业务指标;Grafana 连接 Prometheus,把查询结果组成仪表盘,并在规则满足条件时发出告警。开始排障时,先看响应时间、流量和错误率,确认问题是全站性、某个服务,还是某个时间段的局部异常。
Loki:先用稳定分类缩小日志范围
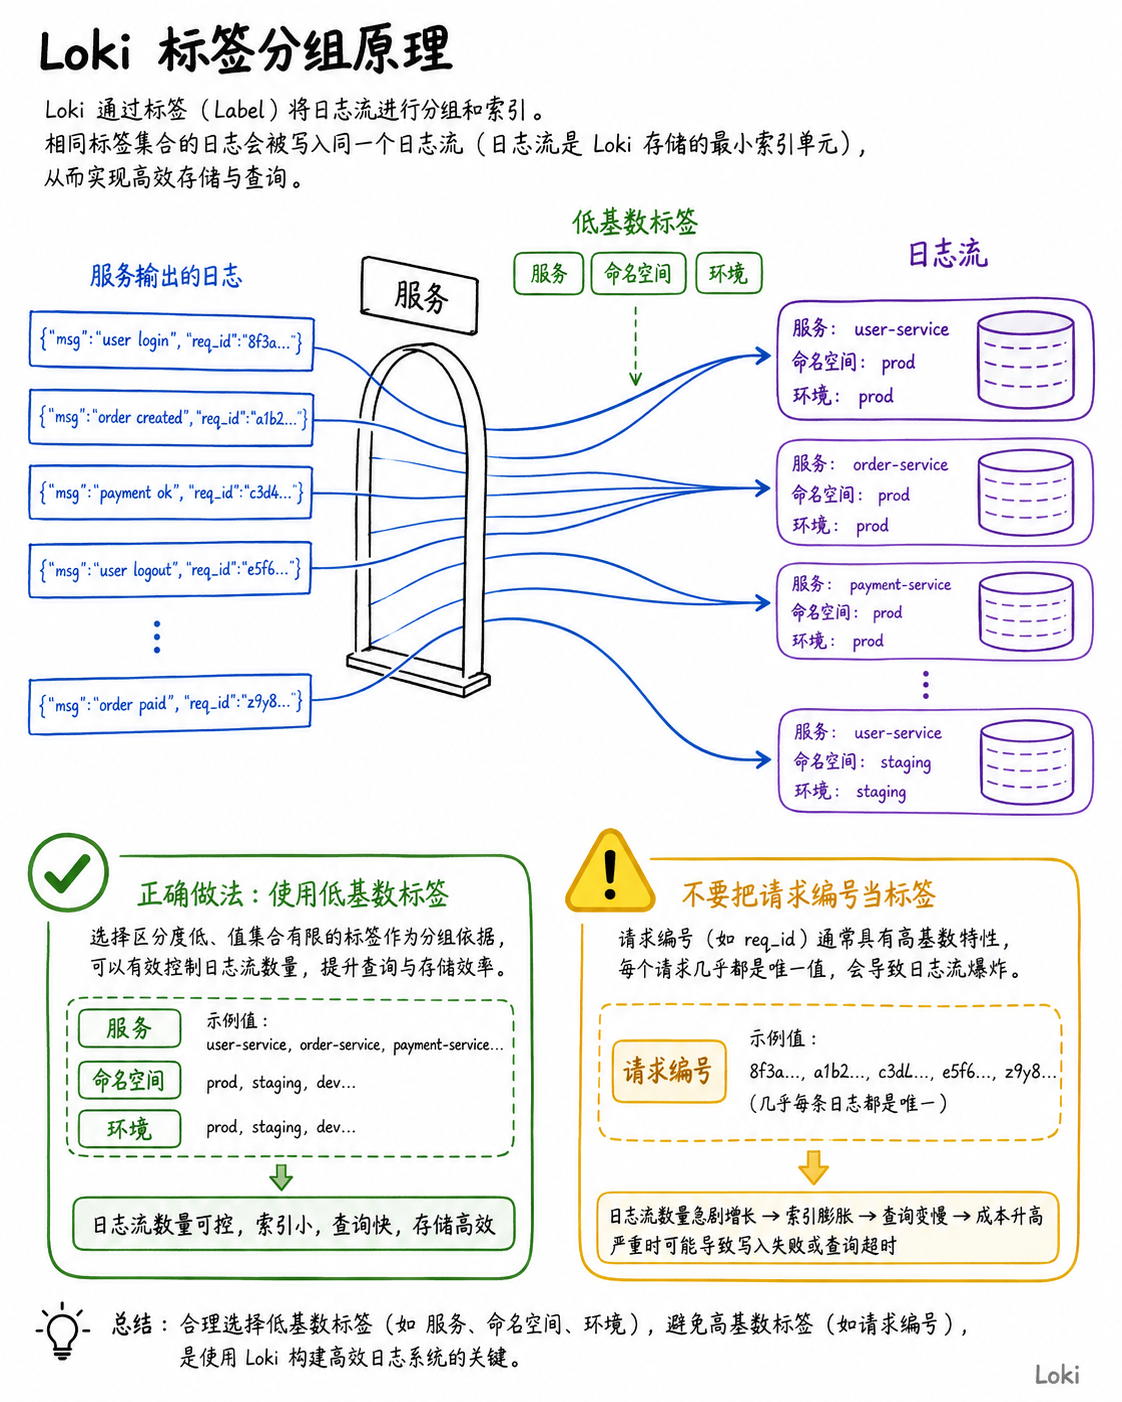
Loki 先使用服务、环境、命名空间等稳定分类信息缩小查找范围。
日志量很大时,第一步不应是全文翻找。Loki 主要索引日志流的标签元数据,例如服务、环境和命名空间;这些维度数量有限且变化稳定,适合用来先锁定一组相关日志。用户编号、请求编号、Trace ID 等几乎每次都变化的值,不宜直接做标签,否则分类组合会快速失控。
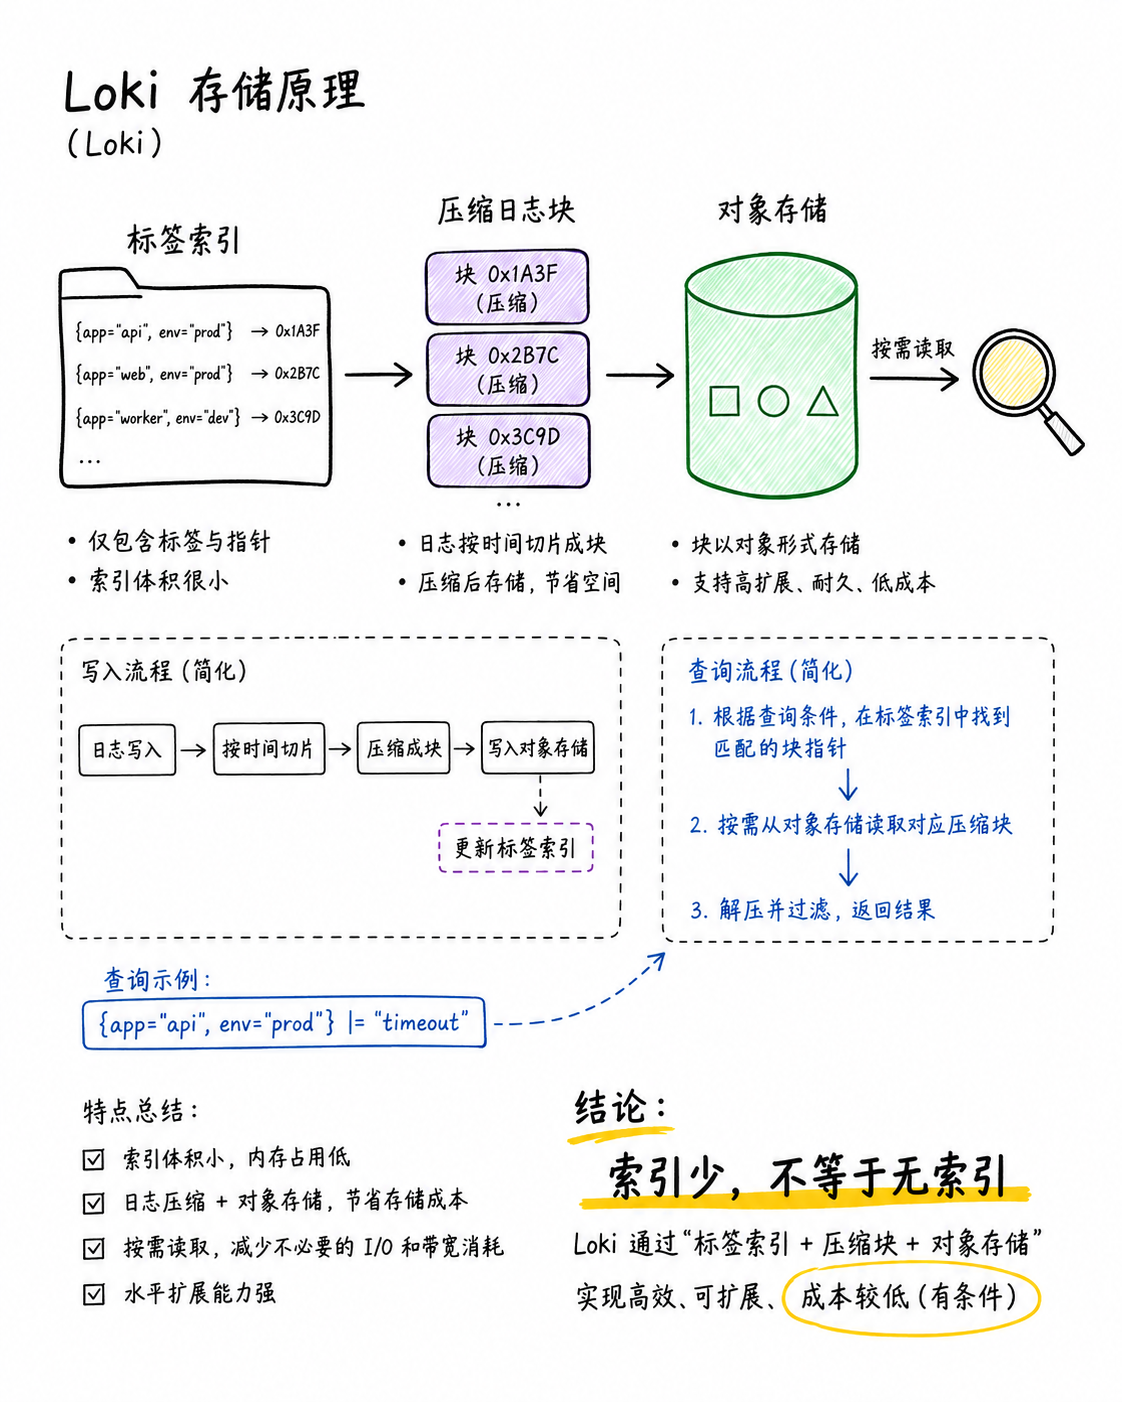
确定日志流后,再读取压缩日志块,是 Loki 降低索引负担的关键取舍。
Loki 并不是“完全没有索引”:它索引标签,然后把日志内容压缩为块,常放入对象存储或本地文件系统,在查询时再做内容过滤。较小的索引量和压缩存储可能降低保存成本,但实际成本和查询表现仍取决于流量、保留周期、标签设计和对象存储配置,不能只凭产品口号下结论。
OpenTelemetry:统一采集,而不是替你自动修复问题
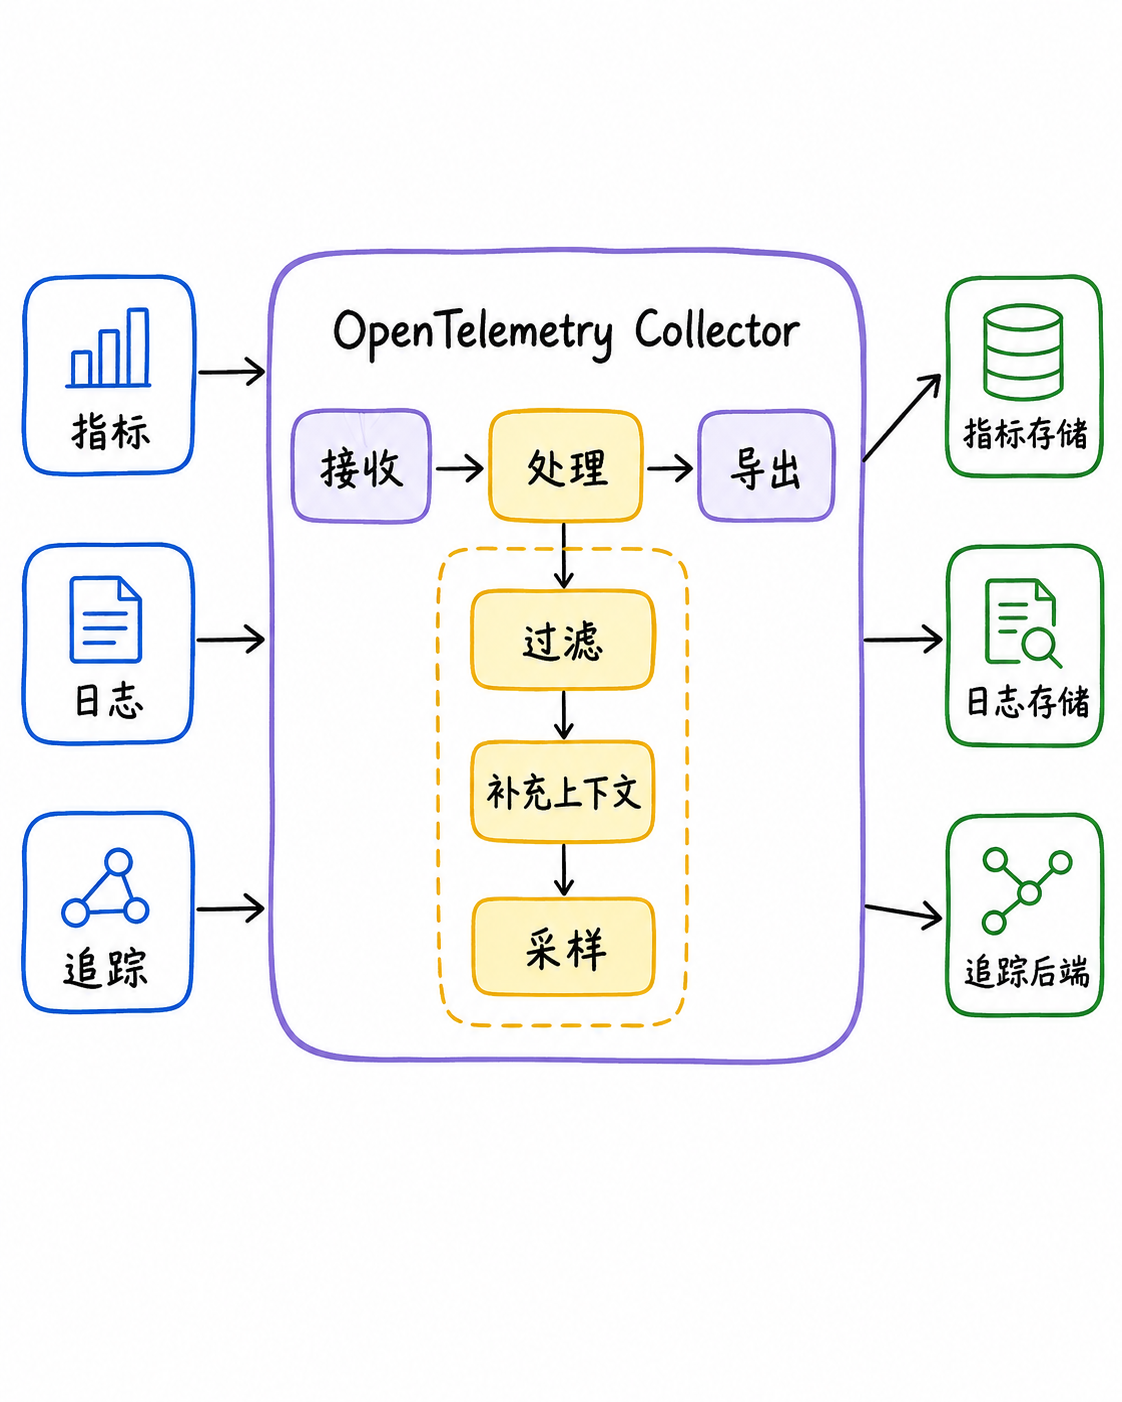
OpenTelemetry 提供接收、处理和导出的统一采集与传输流水线。
当指标、日志和链路各用一套接入方式时,系统扩大后会越来越难维护。OpenTelemetry 为不同信号提供厂商中立的接收、处理和导出管线:它可以过滤无用数据、补充上下文、重命名字段,或通过采样控制记录量;这些处理步骤需要被明确配置,并不会自动产生高质量的埋点语义。
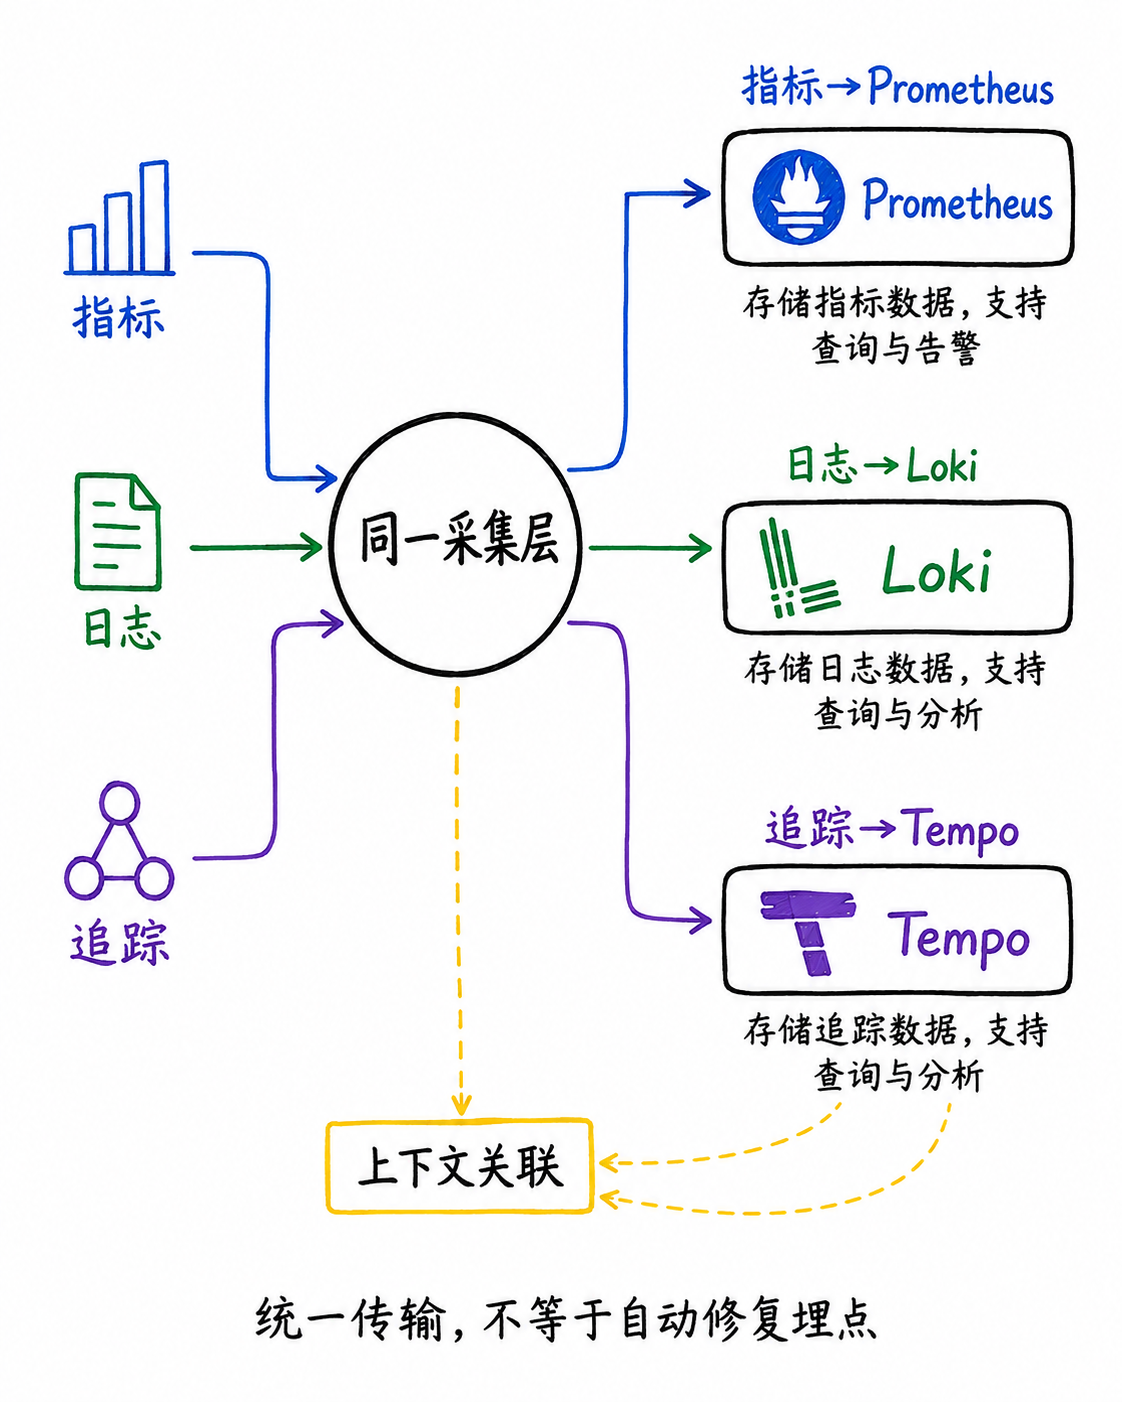
统一采集层让同一份遥测数据可以按信号类型送往合适的后端。
一个常见组合是:指标交给 Prometheus,日志交给 Loki,链路追踪交给 Tempo,Grafana 把这些数据源放入同一个排障视图。OpenTelemetry 解决的是采集和传输的衔接,不会替团队决定后端、采样策略、数据保留周期,也不会弥补错误的业务埋点。
Kubernetes 网站变慢时,按这个顺序查
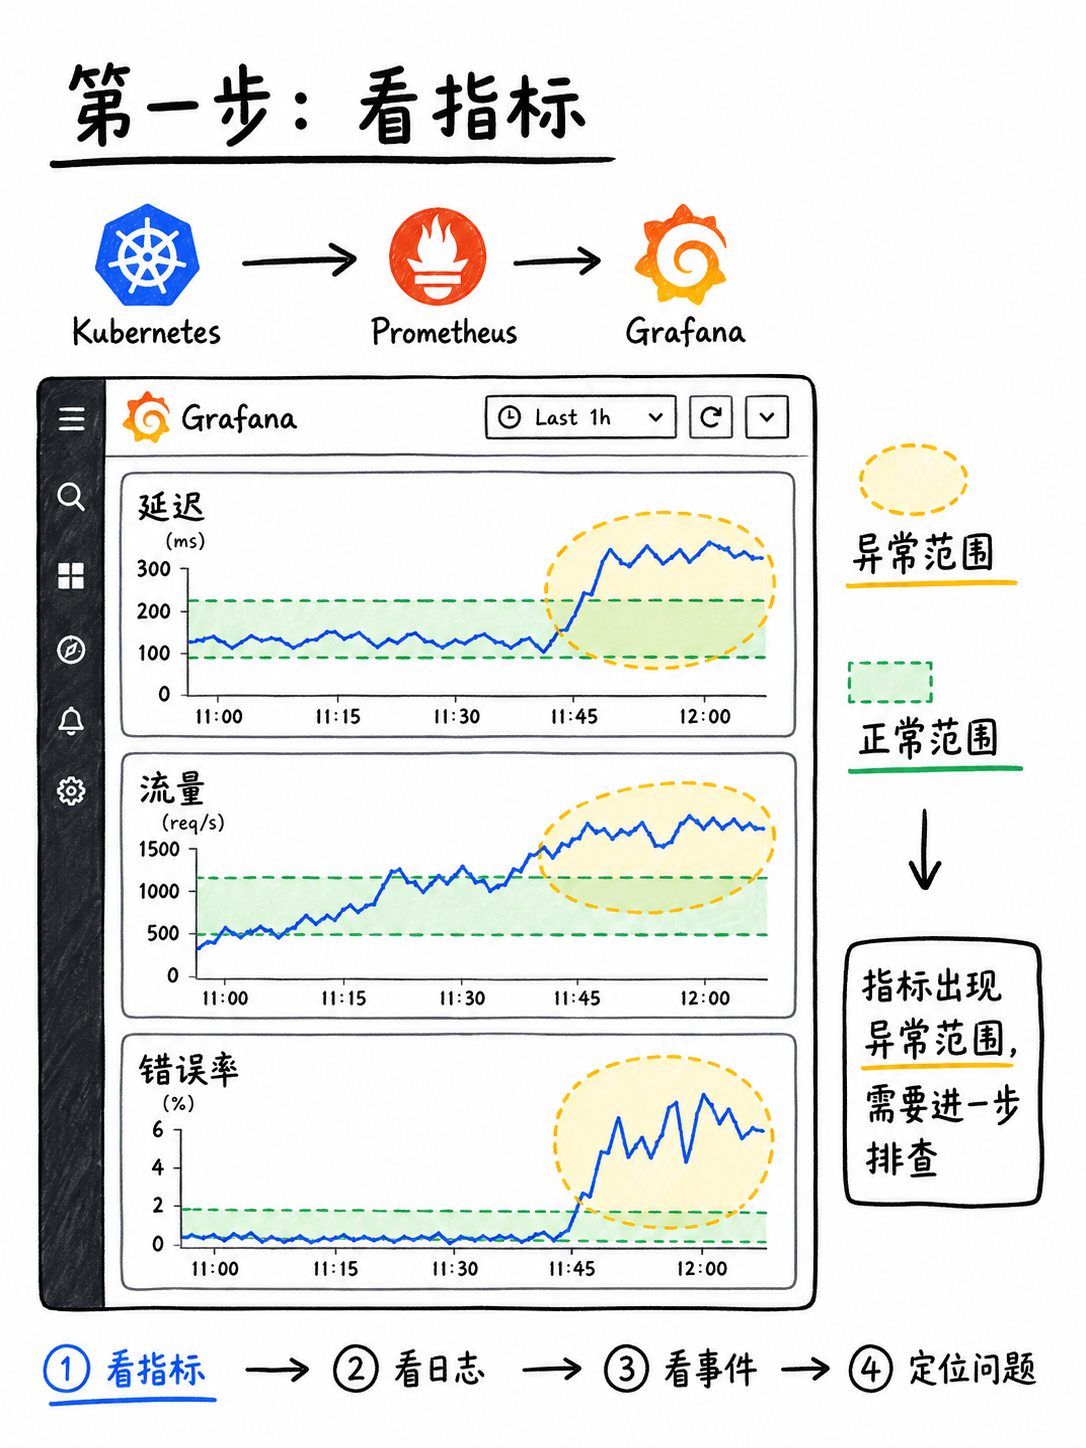
第一步先看指标,判断异常是全站性的,还是集中在特定服务或时间段。
假设 Kubernetes 上的网站变慢,先在 Grafana 中查看响应时间、流量和错误率。如果延迟上升而流量没有明显变化,或错误率只出现在某个服务,就可以把排查范围从整套系统缩小到有迹可循的对象。资源指标也能帮助判断节点或工作负载是否面临 CPU、内存等压力,但业务异常仍要依赖应用自身的指标。
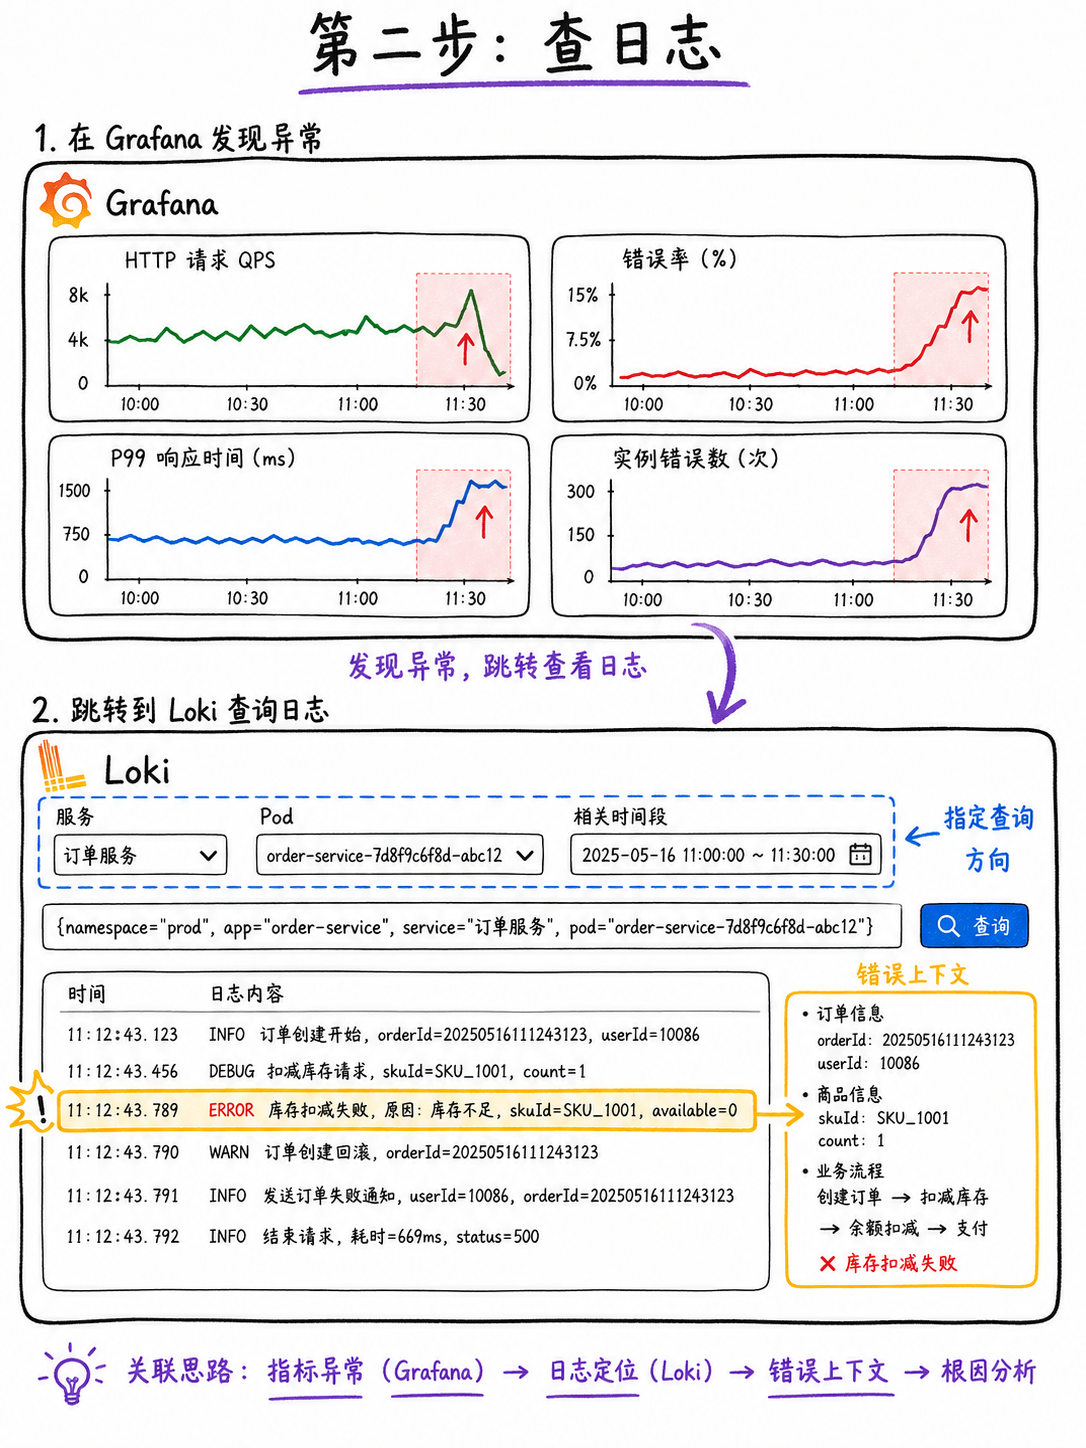
第二步进入 Loki,用已经缩小的服务、时间和实例范围阅读相关日志。
接下来按服务、时间段和服务实例等稳定维度跳转到 Loki,查看错误日志、重试、超时和业务上下文。日志通常能告诉我们哪里出现了异常,但仍要避免因为某一行报错就过早断定它是唯一根因。
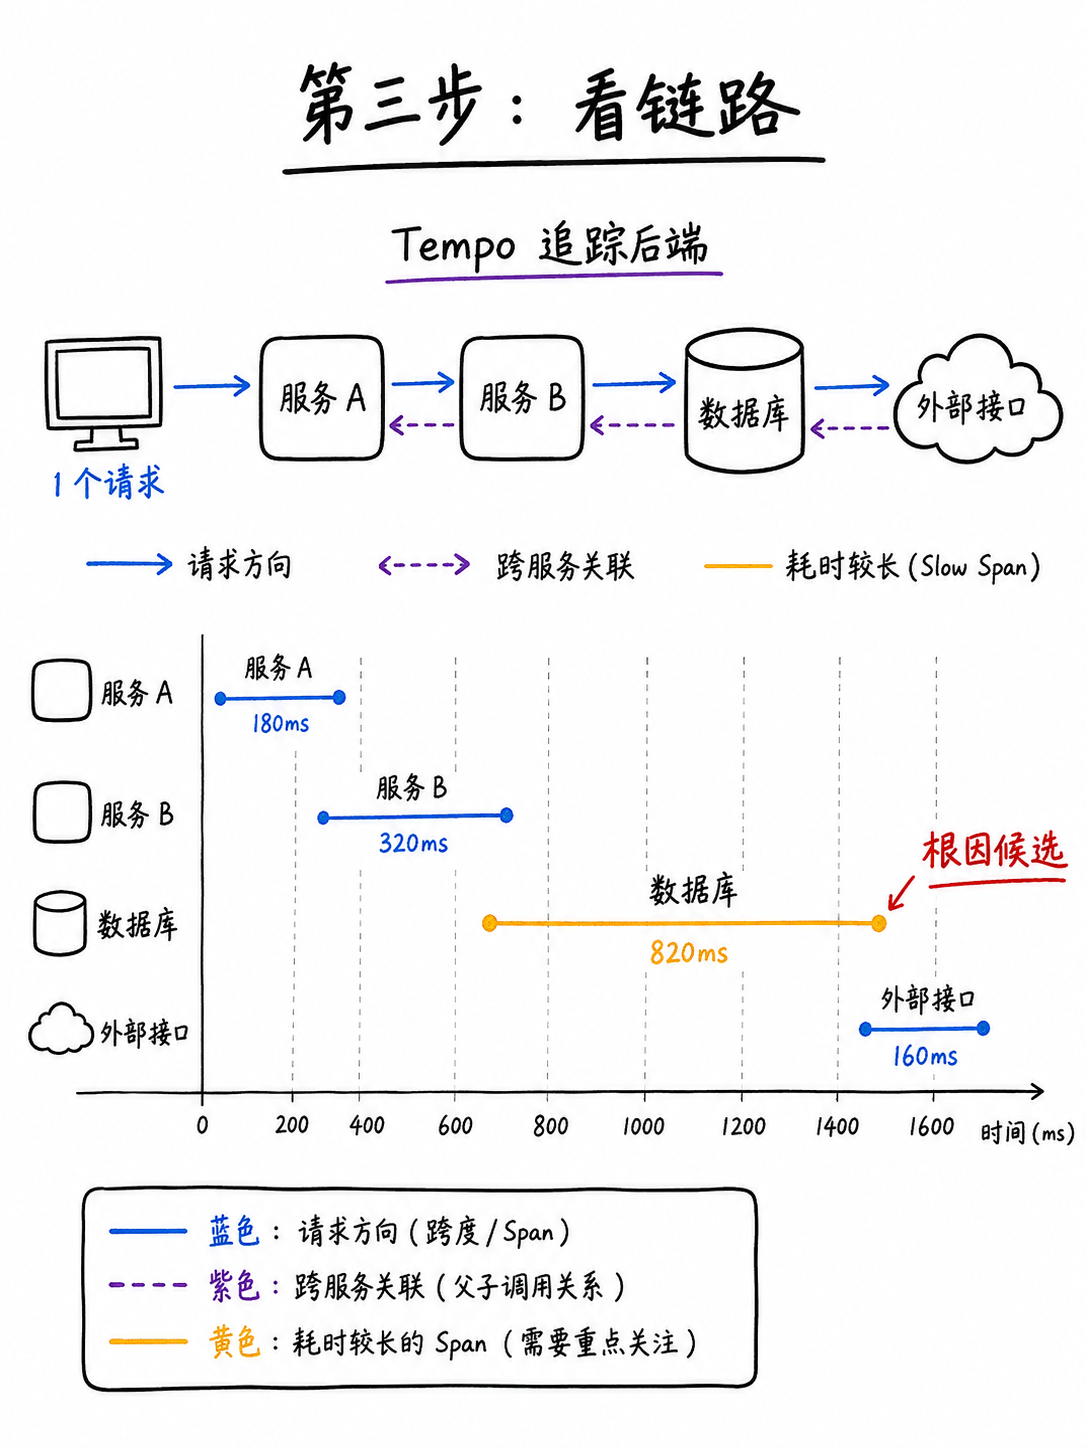
第三步通过链路追踪还原请求路径,定位具体慢在服务、数据库还是外部依赖。
最后使用 Tempo 等追踪后端查看同一请求的调用路径和各段耗时。这样可以区分是应用服务自身变慢、数据库查询拖延,还是外部接口卡住;确认原因后再将告警分组发给相应负责团队,避免一个故障制造大量重复通知。
让观测系统本身也保持可用
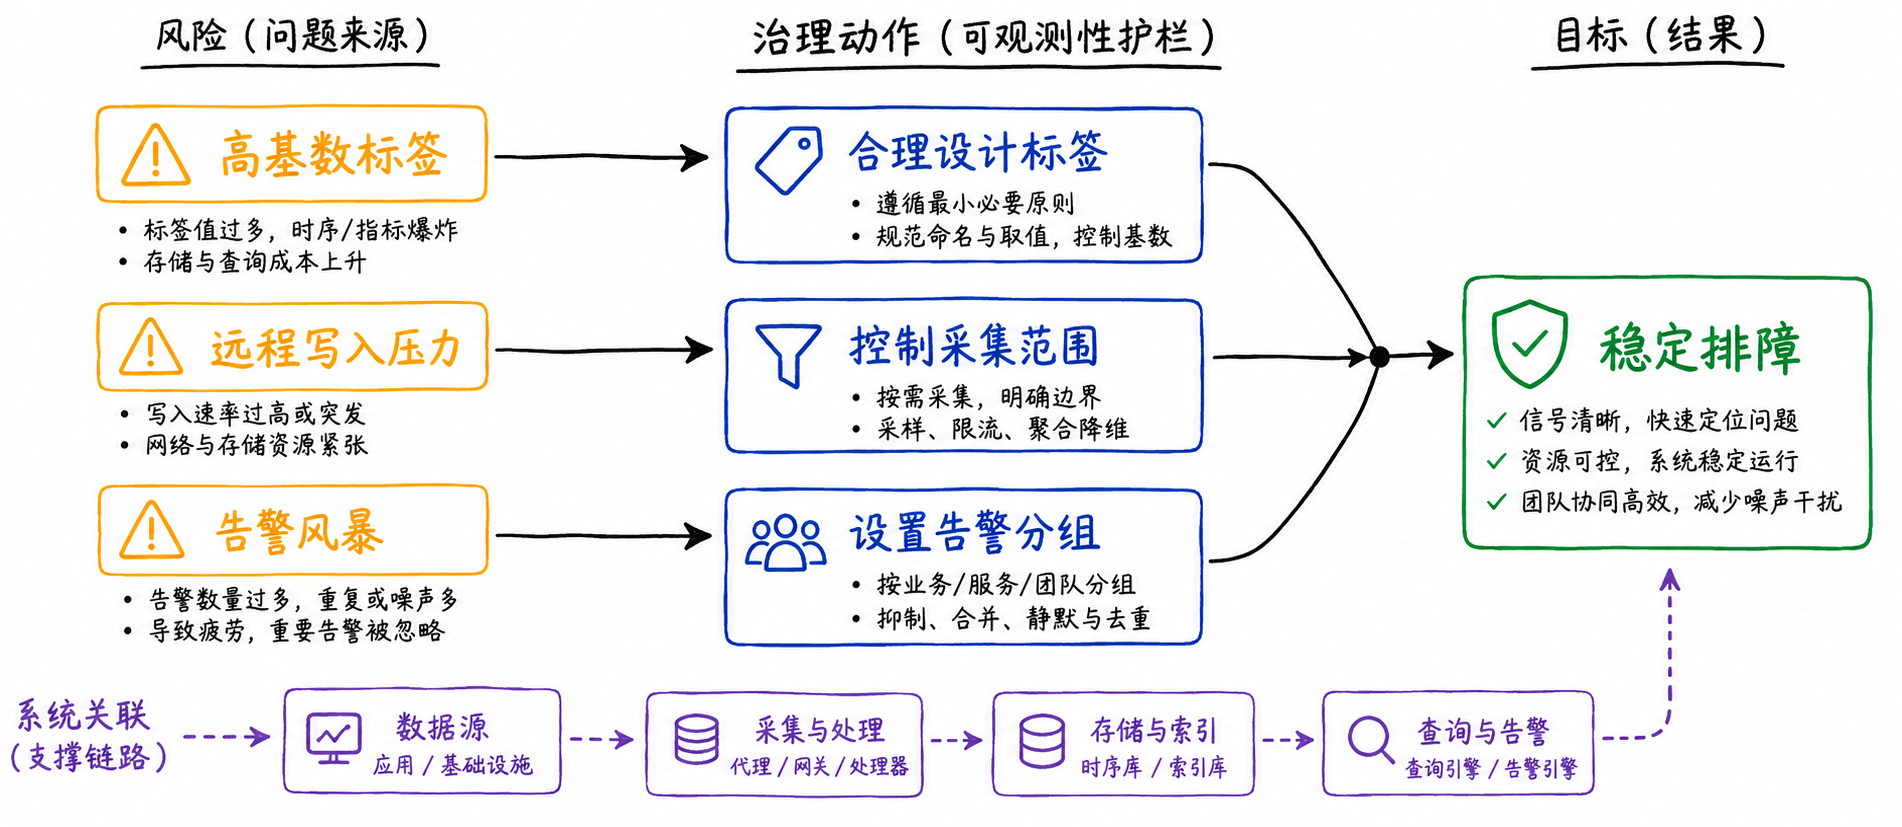
控制数据规模和告警噪声,才能避免监控系统自身成为新的问题来源。
监控系统也会失控:过多动态标签会产生大量时间序列,远程写入可能超过接收端吞吐,重复规则会把一次故障变成告警风暴。实践中应选择数量有限、变化稳定的标签;评估远程写入的发送速度与后端承载能力;并使用告警分组、抑制和合并,确保值班人员看到的是可行动的信号。
结论
Prometheus 三件套不是把三个产品装齐,而是一条清晰的判断路径:Prometheus 看趋势,Loki 查上下文,Tempo 找慢点,Grafana 统一查询、展示和告警;OpenTelemetry 让多种信号更容易接入和导出。 先确认异常范围,再读取事实,最后定位根因,才是比“凭经验猜故障”更可重复的排障方式。
参考资料
📌 查阅提示:点击下方超链接可直接复制对应网址,粘贴至手机或电脑浏览器中即可查阅官方完整技术文档与规范。
【官方资料】Prometheus Overview
说明:官方权威技术规范与开发者实现参考手册。【官方资料】Prometheus Instrumentation
说明:官方权威技术规范与开发者实现参考手册。【官方资料】Grafana data sources
说明:官方权威技术规范与开发者实现参考手册。【官方资料】Loki overview
说明:官方权威技术规范与开发者实现参考手册。【官方资料】OpenTelemetry signals
说明:官方权威技术规范与开发者实现参考手册。【官方资料】OpenTelemetry Collector
说明:官方权威技术规范与开发者实现参考手册。