MySQL、PG、SQLite怎么选?
对应短视频主题:MySQL、PG、SQLite怎么选?
资料核验与更新:2026-09-12
MySQL、PostgreSQL(常简称为 PG)和 SQLite 都能保存关系型数据、使用 SQL 查询,也都支持事务;但它们并不处在同一条“性能排行榜”上。真正需要回答的问题是:数据库运行在哪里、数据关系有多复杂、写入会不会持续并发,以及团队能否长期维护它。
阅读边界
本文依据原始课程的研究笔记、课程结构和发布文案整理。涉及产品、模型、版本、平台规则、价格或资格等可能变化的信息,实践前应以当前官方资料和实际环境为准。
先把问题从“谁最好”改成“谁更匹配”
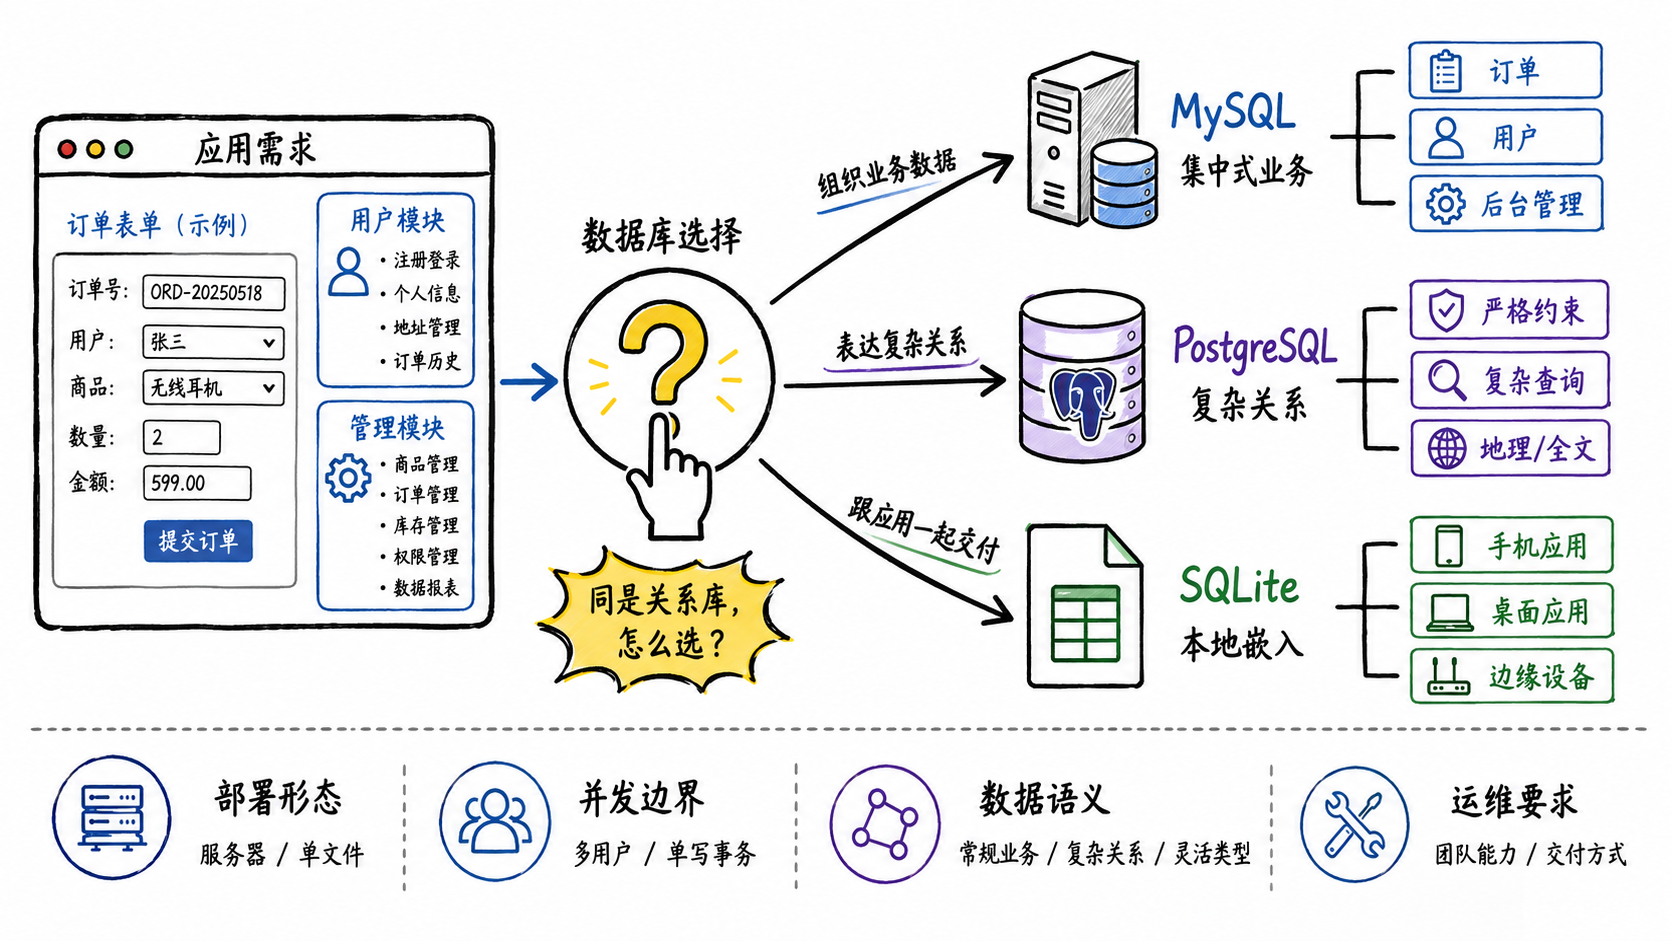
三种关系型数据库的共同起点相同,但服务边界、部署形态与维护方式不同。
选型时,不宜只依据某一张跑分图或某个熟悉的产品名称。集中式业务通常关心多人同时读写、备份恢复和生态工具;复杂数据系统还会关心约束、查询表达力和扩展能力;而本地工具更在意能否随应用一起交付。先确认这些前提,后续的功能比较才有意义。
三种数据库分别适合什么角色
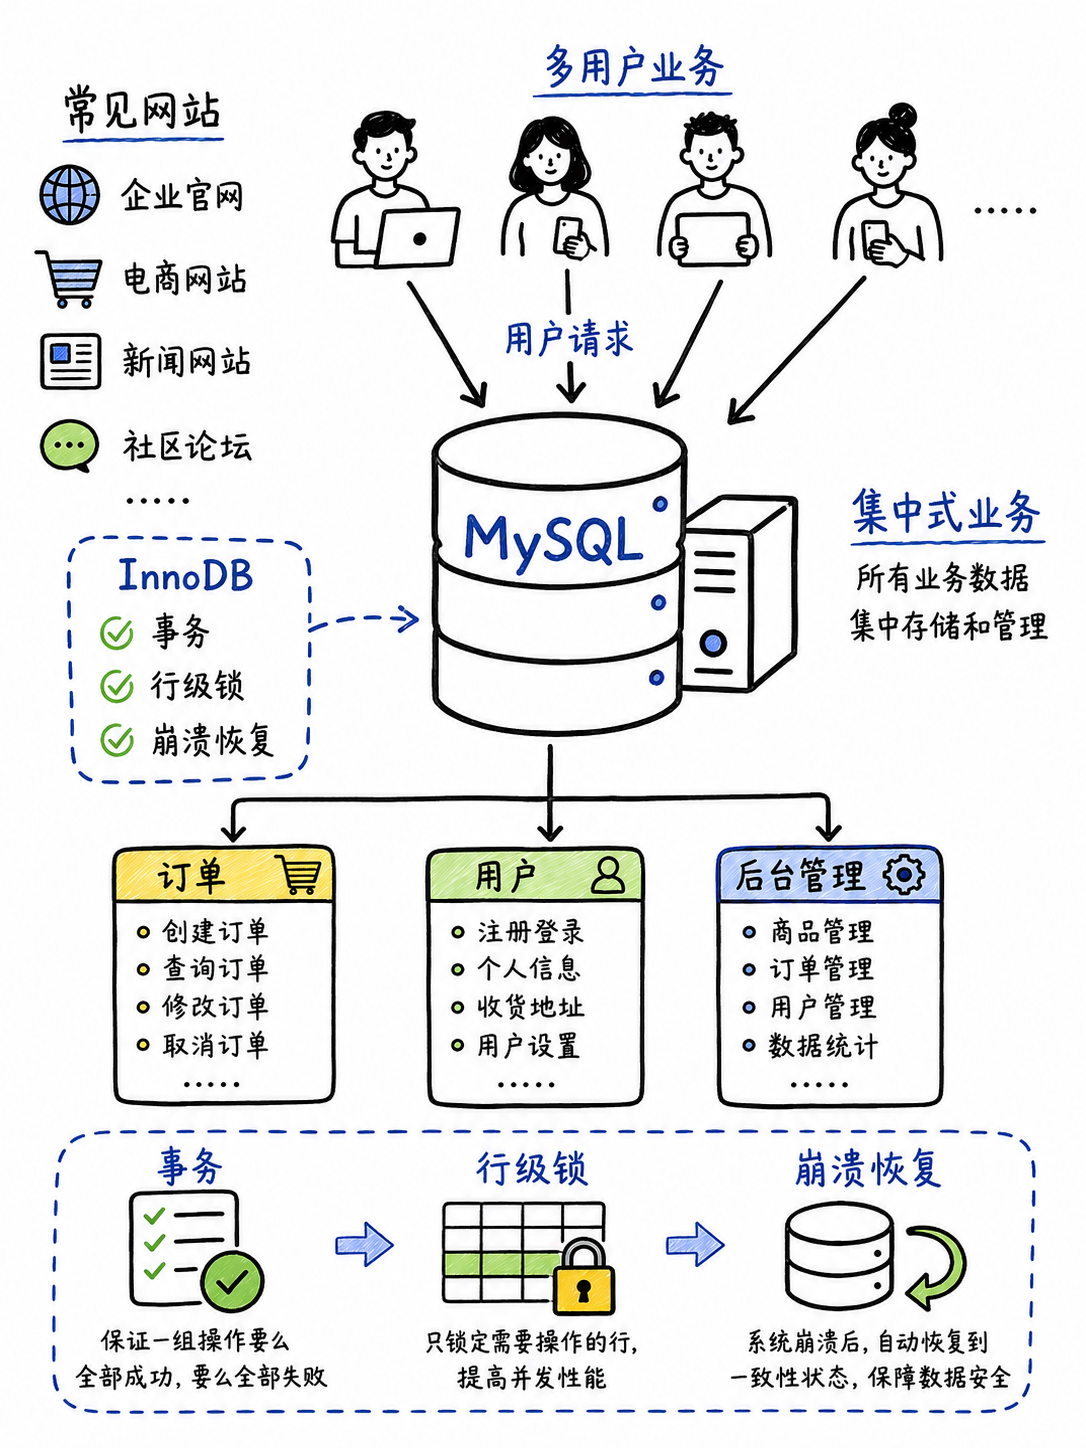
MySQL 常见于网站、订单、用户和后台管理等集中式业务系统。
MySQL 的价值通常不在于“任何场景都最强”,而在于通用业务中的成熟度:开发、运维、托管服务和周边工具都较容易找到经验。讨论事务、行级锁、崩溃恢复与一致性读时,要明确这些能力在 MySQL 中应以 InnoDB 存储引擎为前提,不能笼统归因于所有存储引擎。
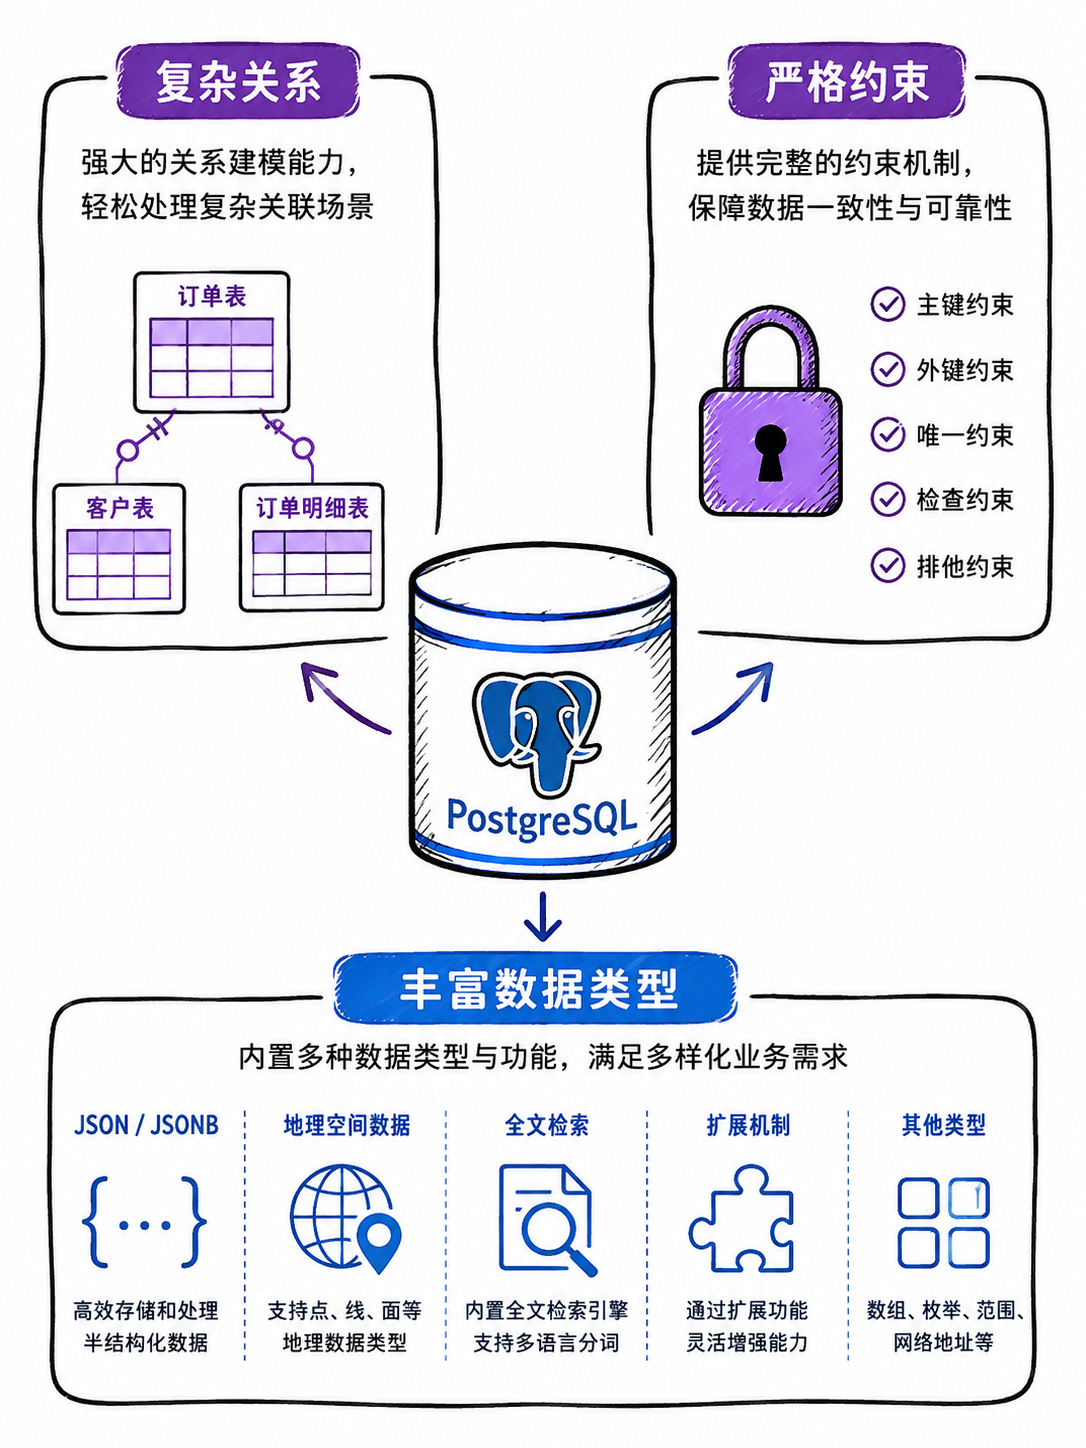
PostgreSQL 更适合优先评估复杂数据语义、严格约束与查询表达能力的系统。
PostgreSQL 的教学定位不应是“高级版 MySQL”。它适合被当作一套重视数据语义的关系型数据库来评估:丰富的数据类型、约束、事务隔离、复杂查询和可扩展能力,都可能直接影响系统是否能准确表达业务规则。地理信息、全文检索、半结构化数据或复杂关联查询,是值得优先研究它的典型信号。
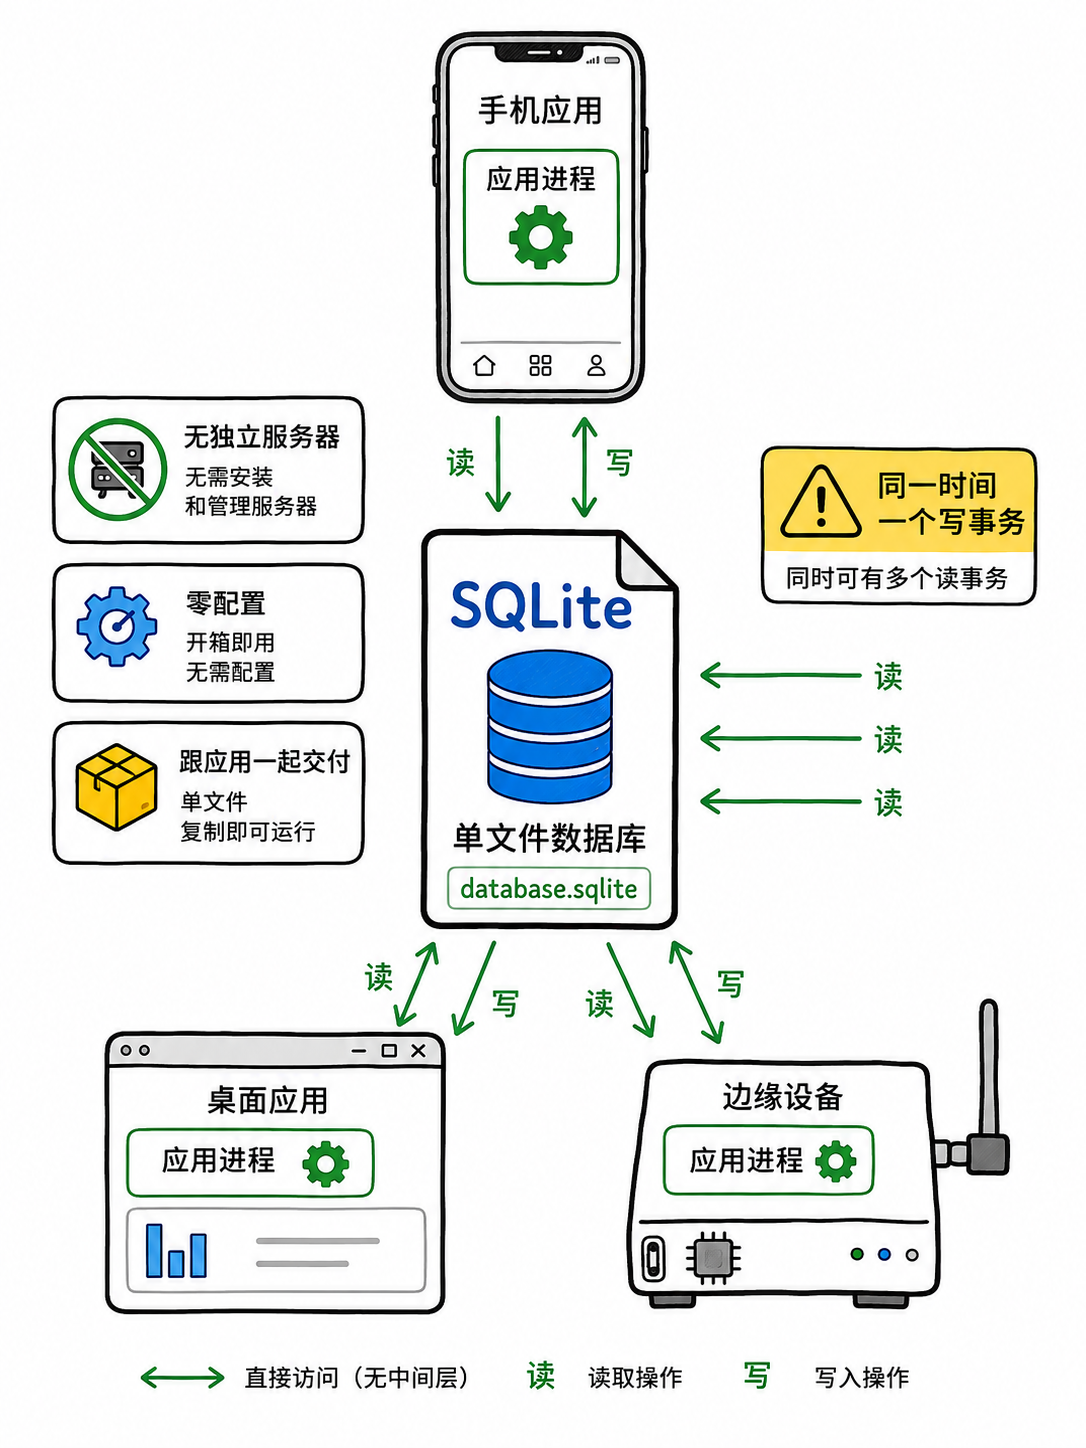
SQLite 跟随应用进程运行,以单一数据库文件完成本地数据存储。
SQLite 没有需要单独维护的数据库服务器,应用可以直接读取和写入数据库文件。这使它特别适合桌面软件、移动端、本地工具、测试夹具、边缘设备和需要极简交付的产品。它并非“功能残缺的服务器数据库”,而是为嵌入式和单机边界设计的事务型 SQL 引擎。
并发与事务的边界必须提前确认
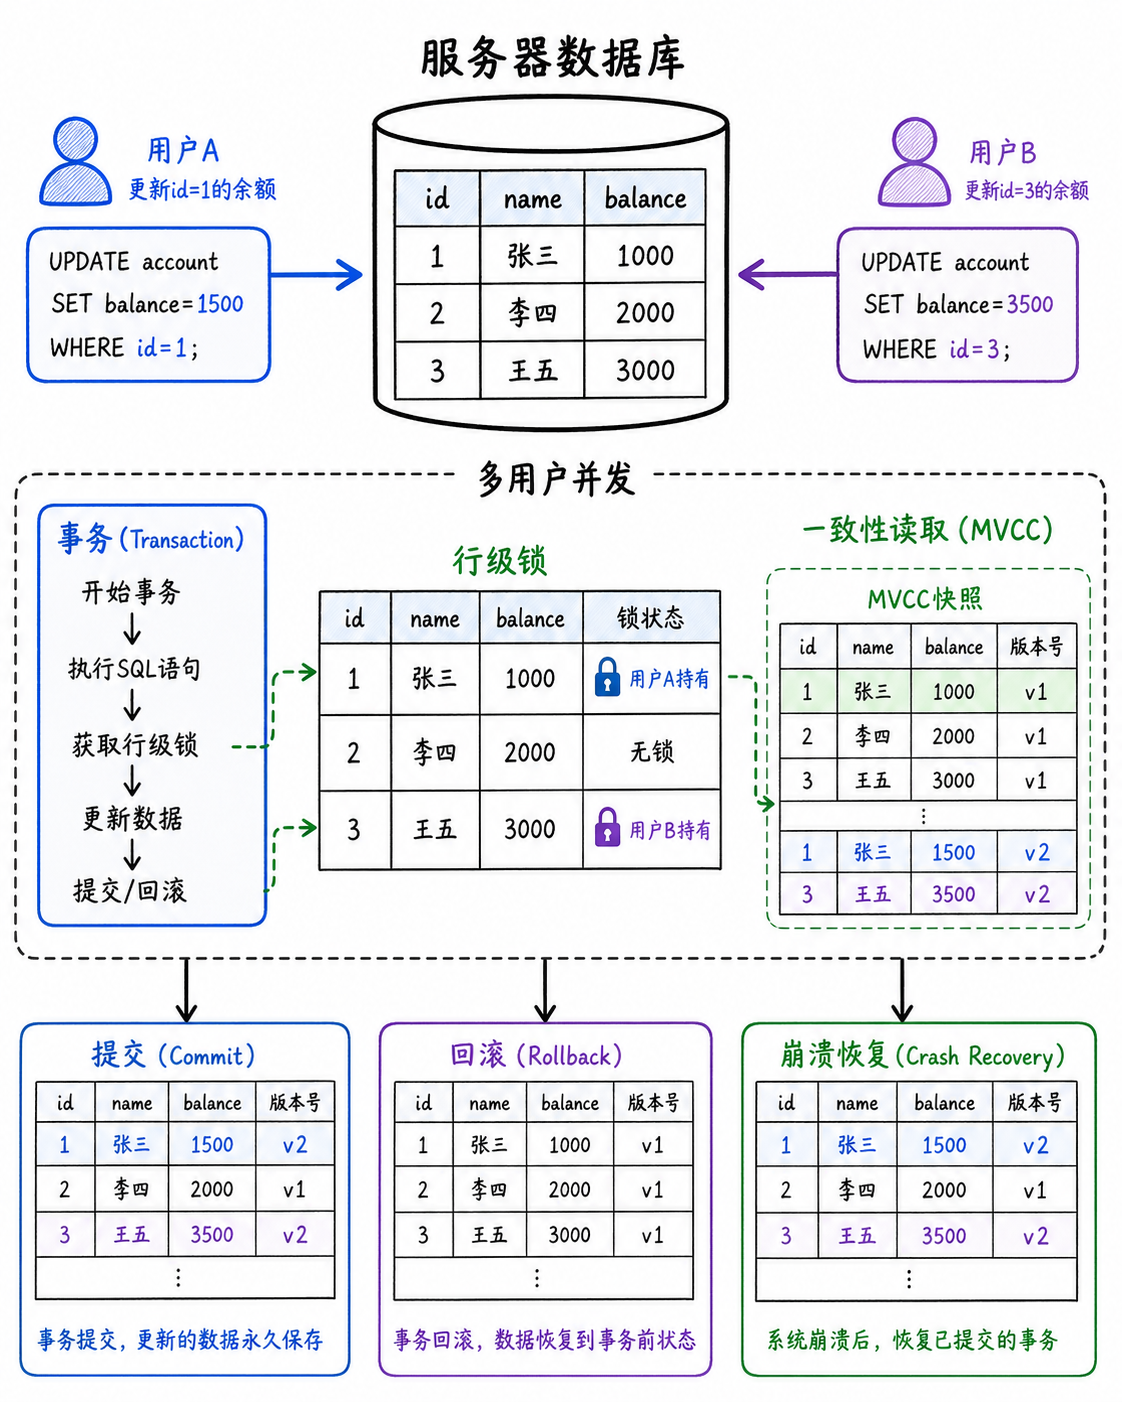
MySQL(InnoDB)和 PostgreSQL 都需要围绕事务、并发控制与恢复能力来设计服务端读写。
事务可以理解为“一组操作要么一起成功,要么都不生效”。对于订单、库存、支付状态等数据,这比单条 SQL 能否执行更重要。MySQL 的 InnoDB 提供事务模型、行级锁和一致性读;PostgreSQL 也使用多版本并发控制等机制处理并发可见性。具体的隔离级别、锁等待和死锁处理仍要在真实业务中测试,不能用一句“都支持 MVCC”替代设计。
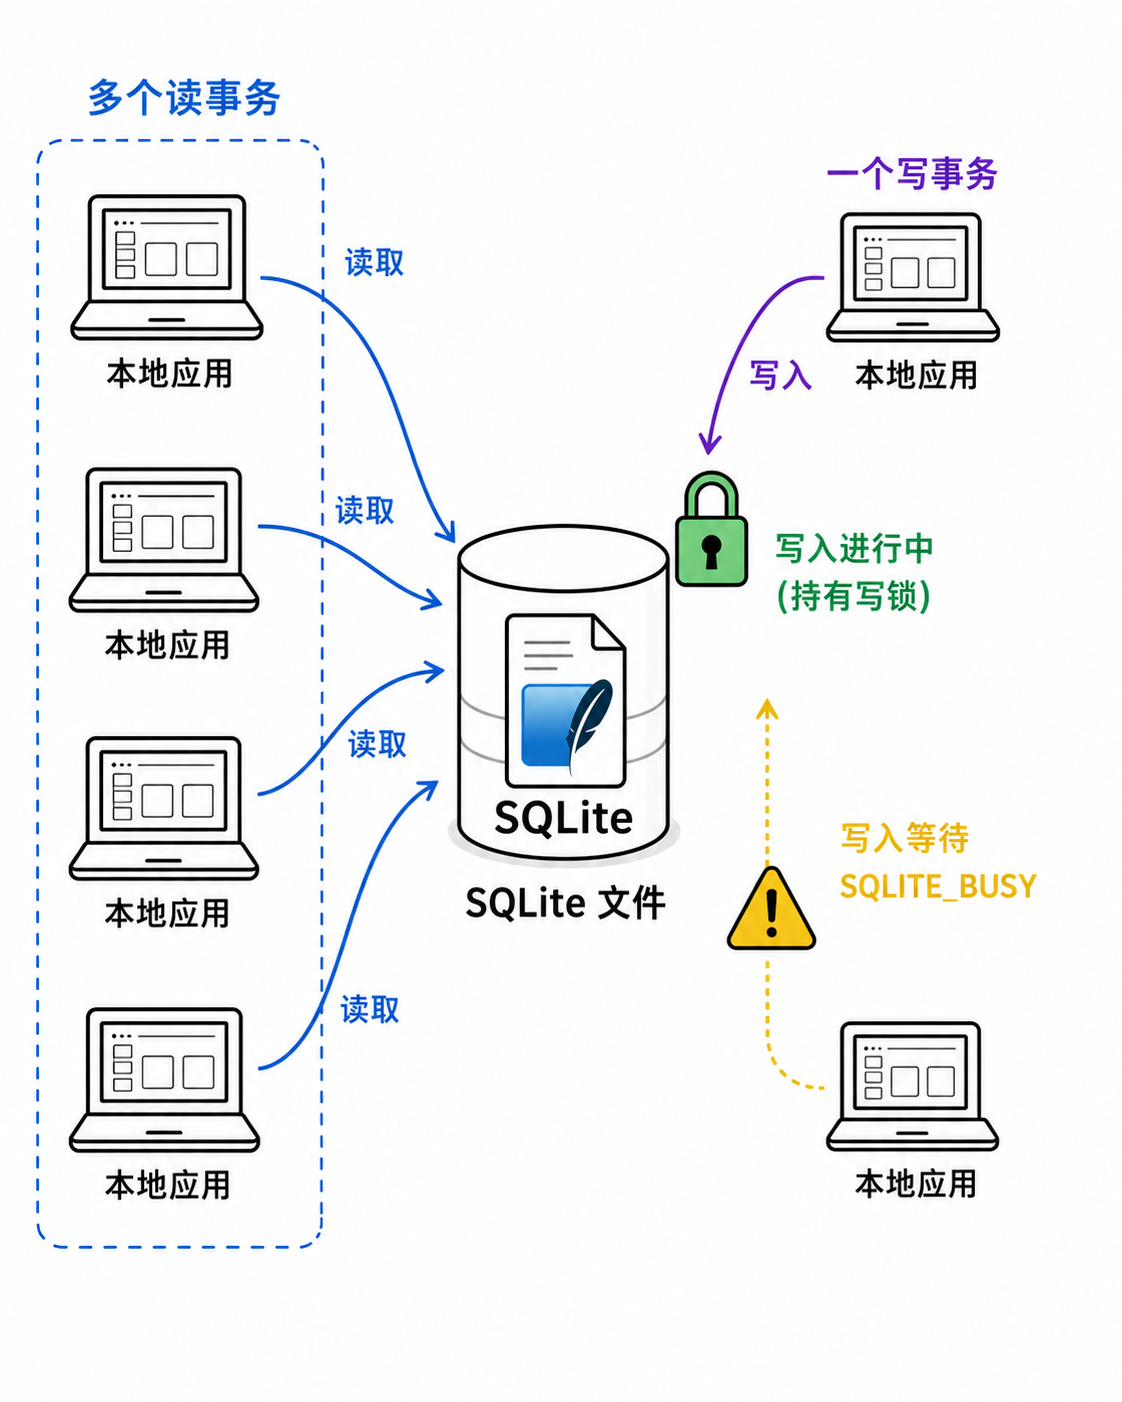
SQLite 可以并发读取,但同一个数据库文件在同一时刻只能有一个写事务。
这条边界并不意味着 SQLite 不能用于事务或不能被多个组件读取;它说明持续、高并发、多机共享写入不是它的优势场景。若应用频繁争抢同一文件的写权限,或者数据库文件被多个机器经网络共享,应重新评估服务器型数据库与相应的部署方式。
用统一维度比较,而不是机械排名
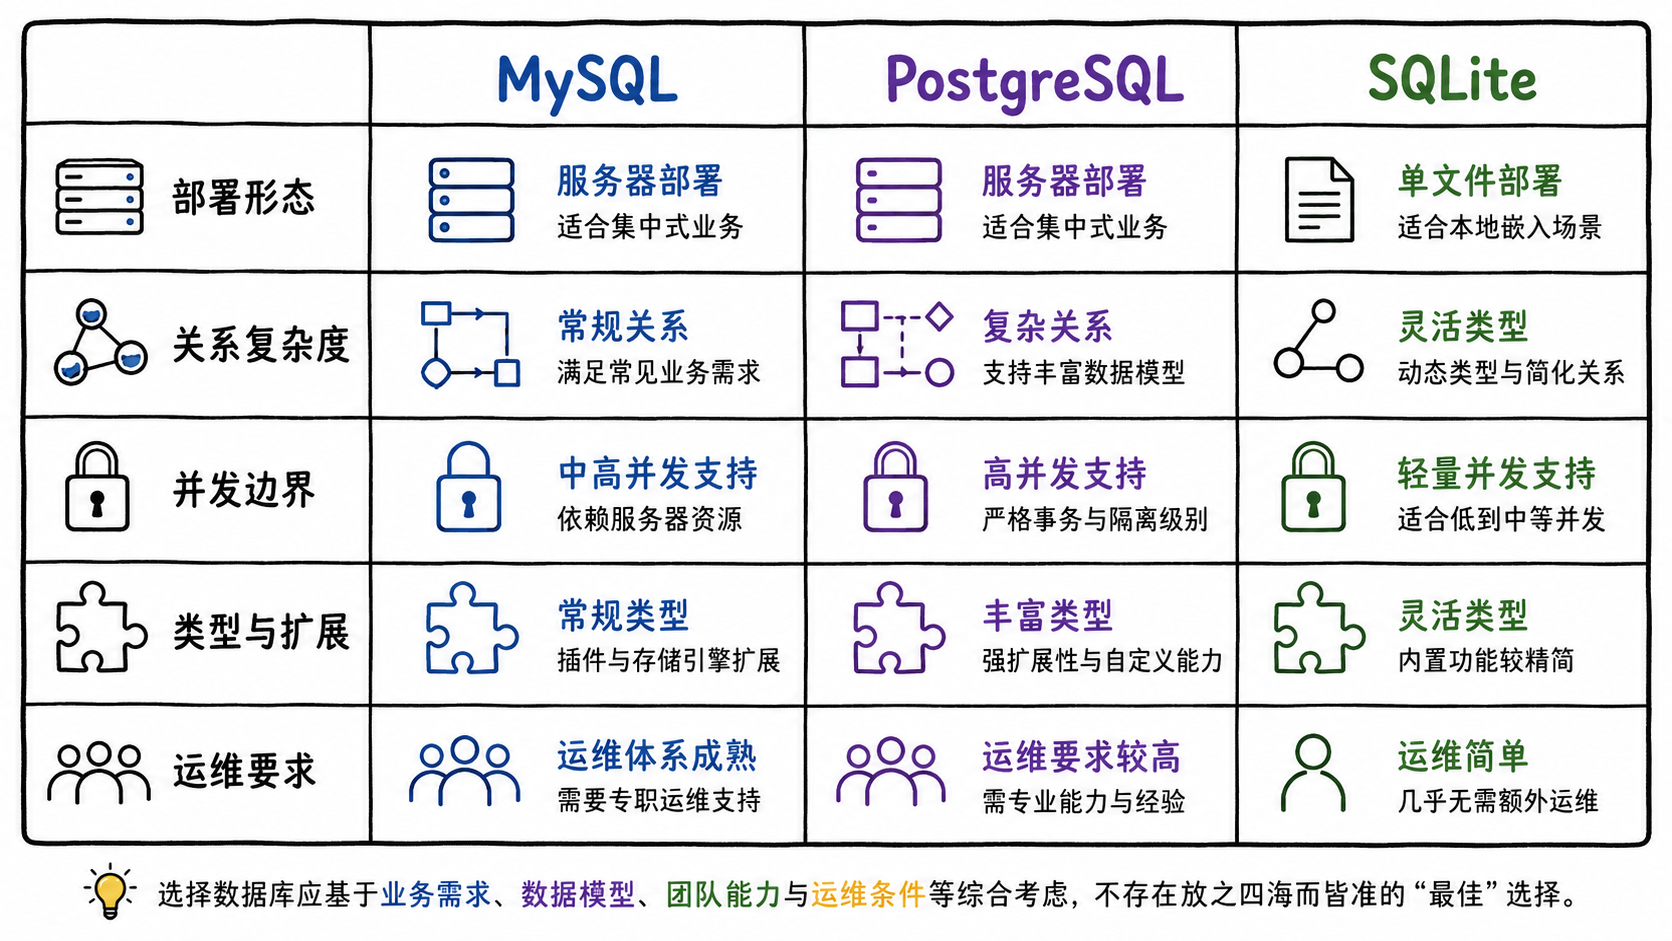
数据库选型可从部署位置、关系复杂度、写入并发、类型与扩展需求、运维负担等维度展开。
一个实用的起点是:集中式通用业务先评估 MySQL;关系更复杂、规则更严格或查询表达要求更高时先评估 PostgreSQL;应用内本地存储、单文件交付和较少运维负担时先评估 SQLite。这只是候选顺序,不是绝对结论。数据量、写入峰值、备份恢复目标、合规要求和团队已有能力都可能改变结果。
迁移时,真正迁移的是数据语义和运行行为
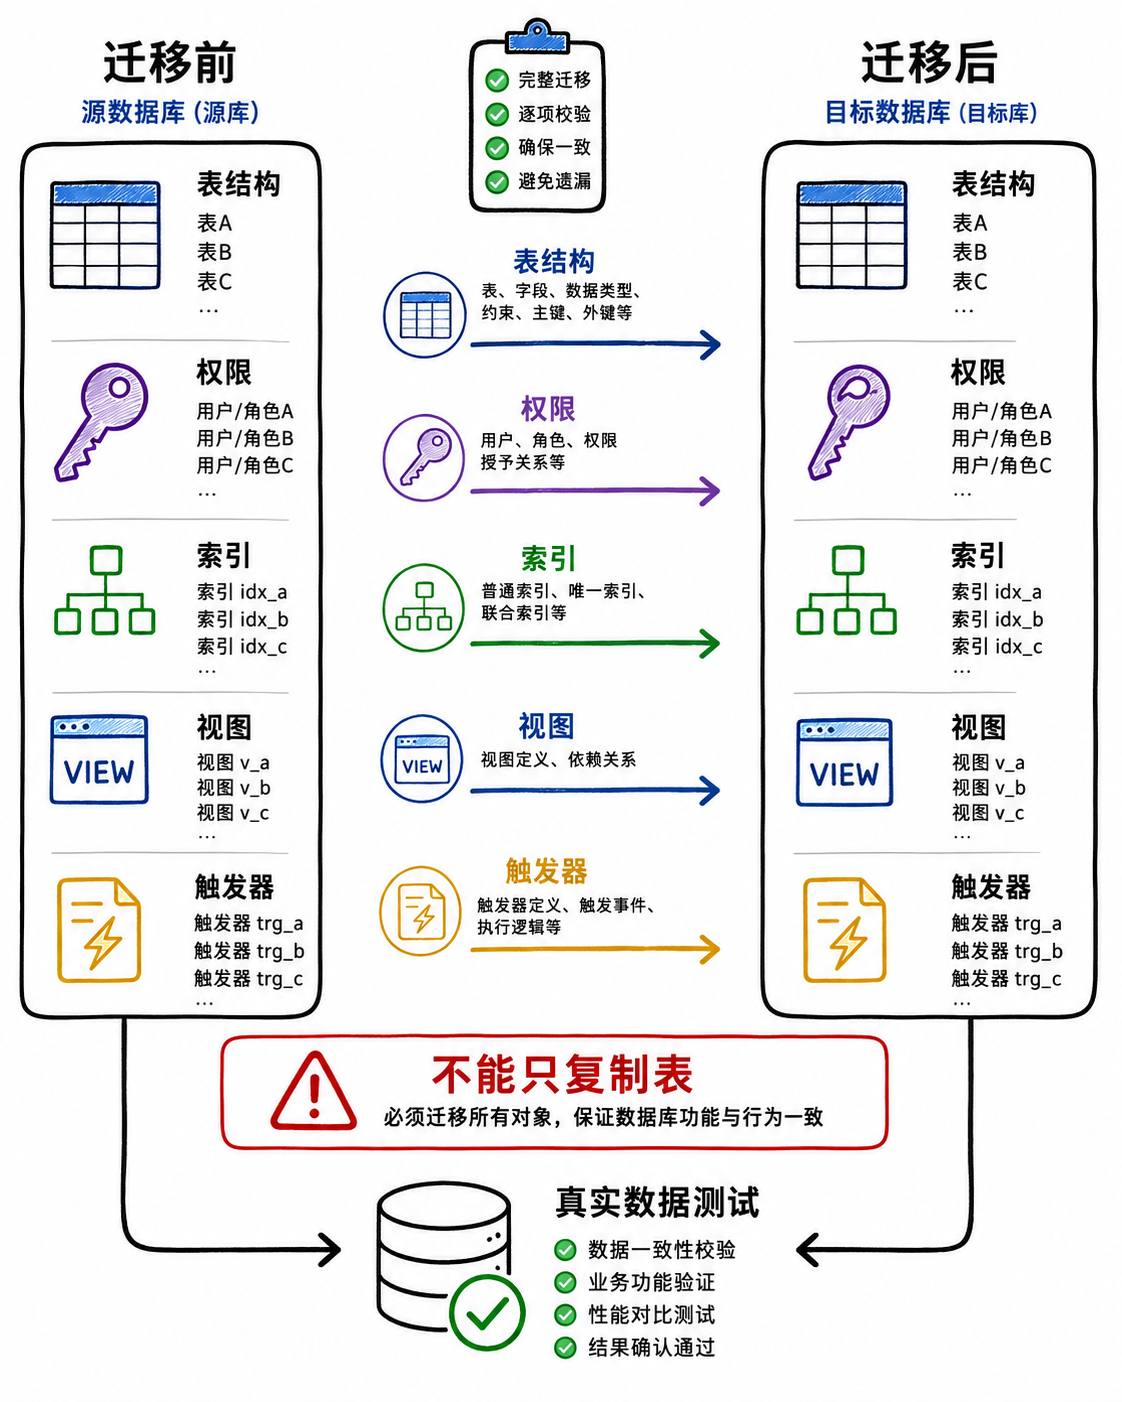
导出并导入数据表只是迁移的开始;模式、权限、索引、视图与触发器也需要逐项核对。
迁移项目常见的误区是“表创建成功,就说明迁移成功”。实际系统依赖的不只有列名和数据行:外键、唯一约束、默认值、权限、索引、视图、触发器、分页查询和错误处理都可能在新数据库中表现不同。迁移计划应把这些对象列入清单,并安排可回滚的验证阶段。
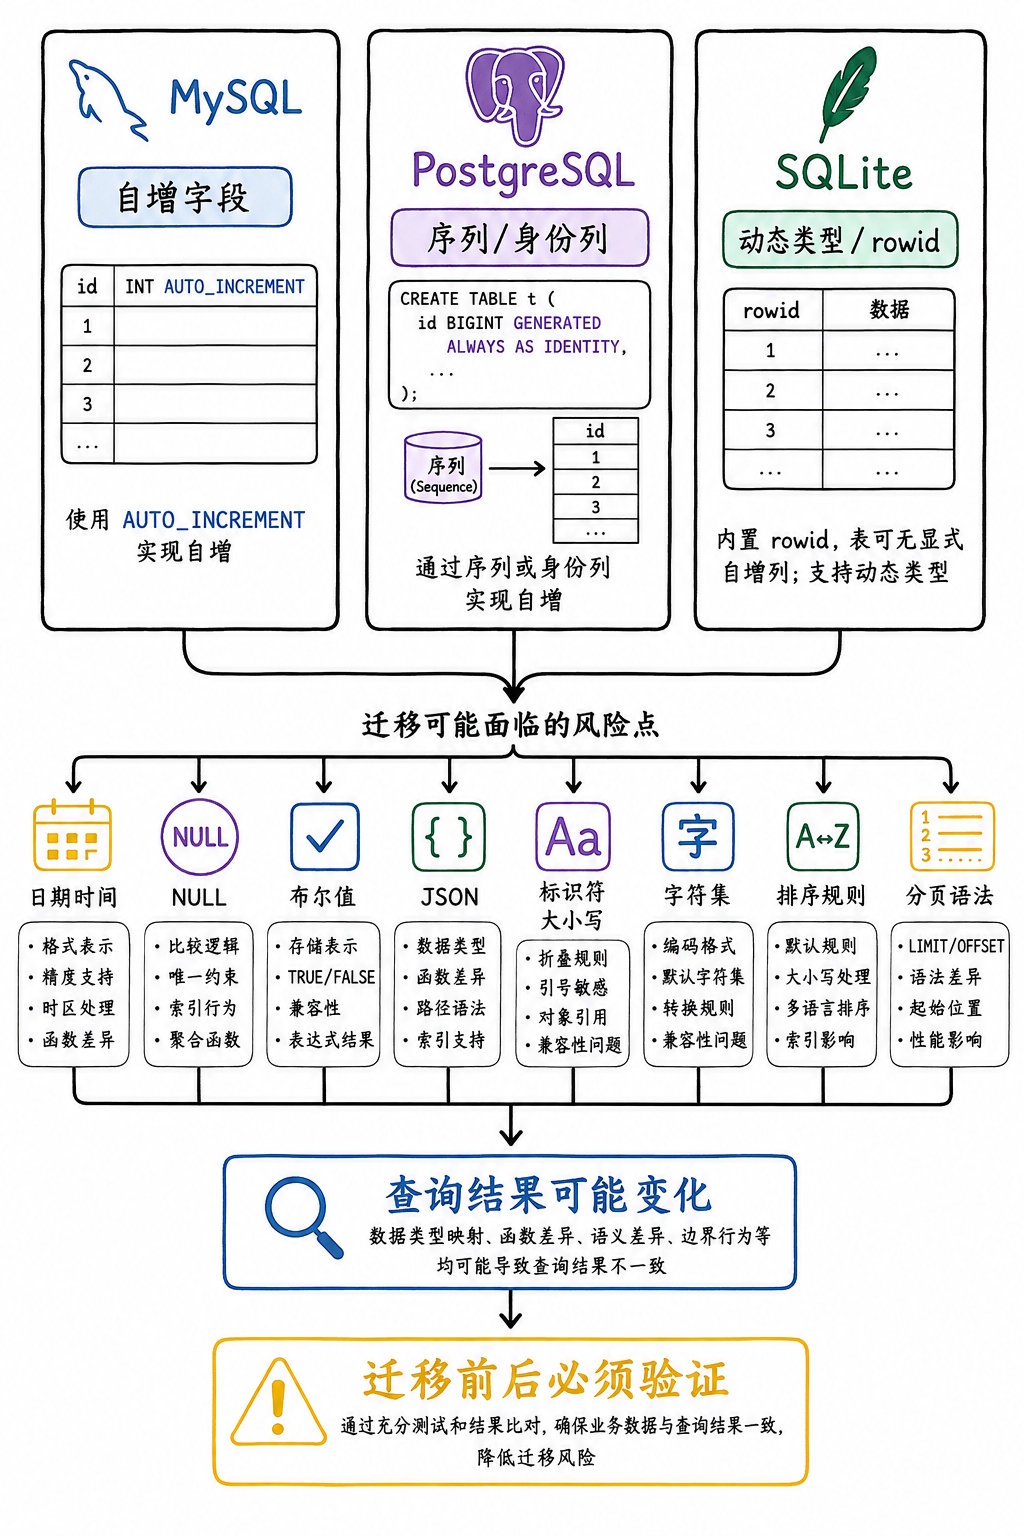
主键生成与类型语义在三种数据库间并不完全相同,必须用真实样本验证。
例如,MySQL 的自增字段、PostgreSQL 的序列或身份列,以及 SQLite 的动态类型和 rowid 机制,都不应靠名称相似就视为等价。日期时间、空值、布尔值、JSON、大小写、字符集和排序规则同样会影响查询结果。SQLite 还提供 STRICT 表等能力,因此也不宜把它简单描述为“所有列都完全无类型”。
把选择放回真实项目
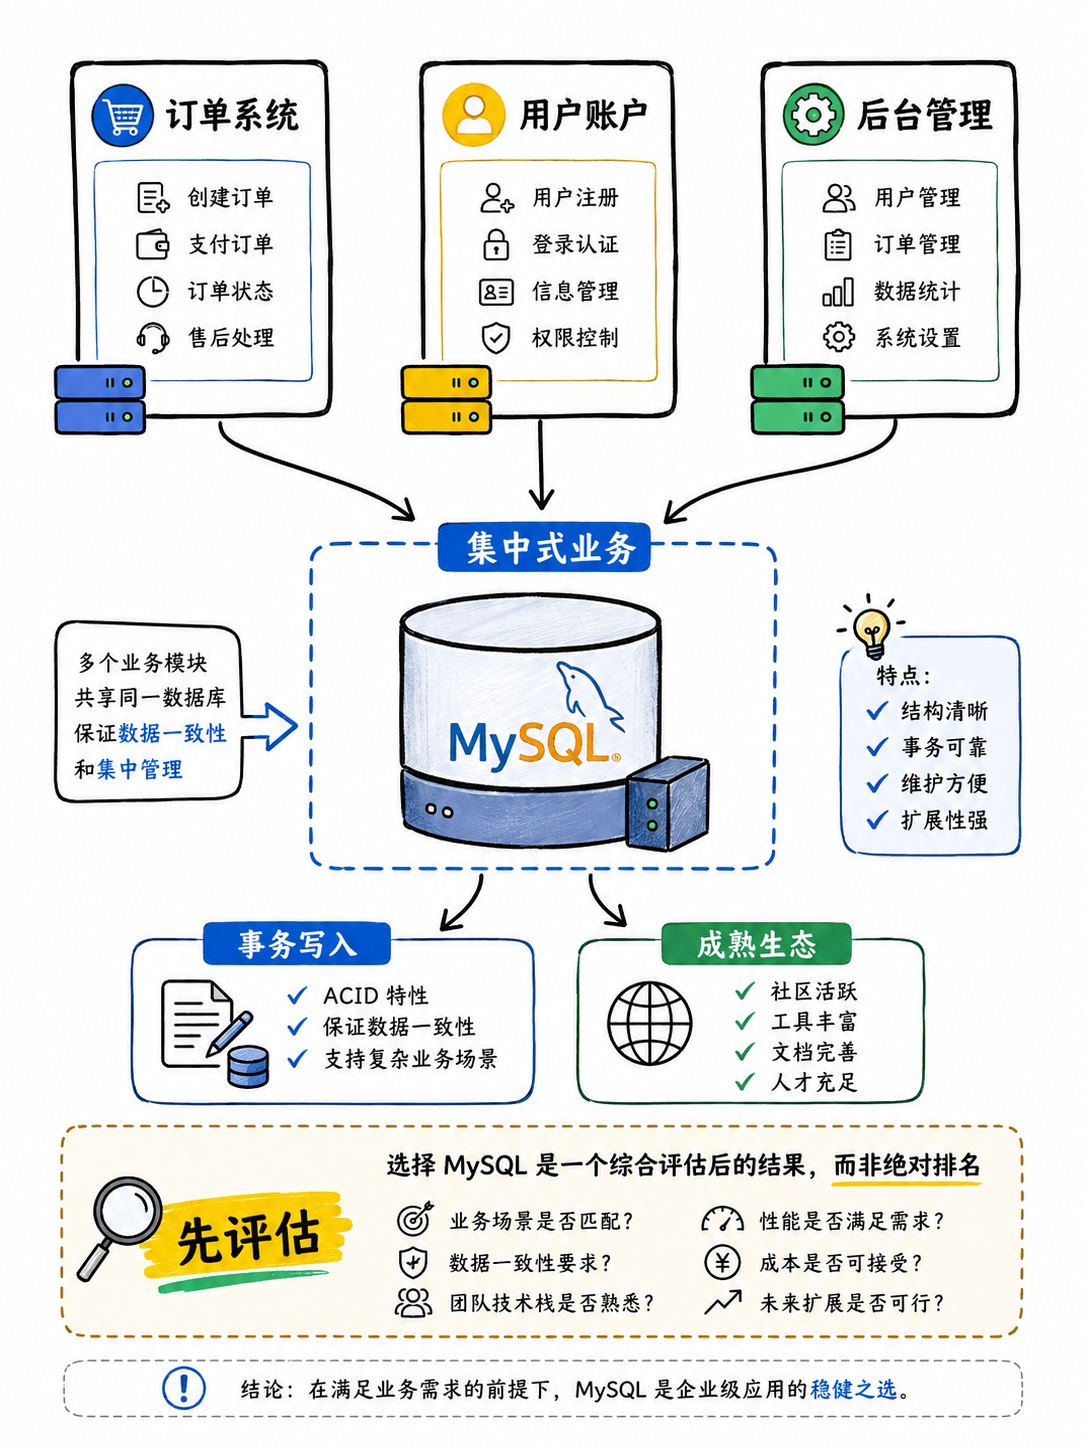
对于订单、用户和后台管理等常见业务,MySQL 通常是值得优先评估的起点。
这类系统往往需要稳定的服务端部署、多人协作、日常备份和成熟的周边工具。是否最终使用 MySQL,仍应通过实际的事务边界、索引设计、写入峰值和故障恢复演练来确认,而不是只因项目类型相似就直接定案。
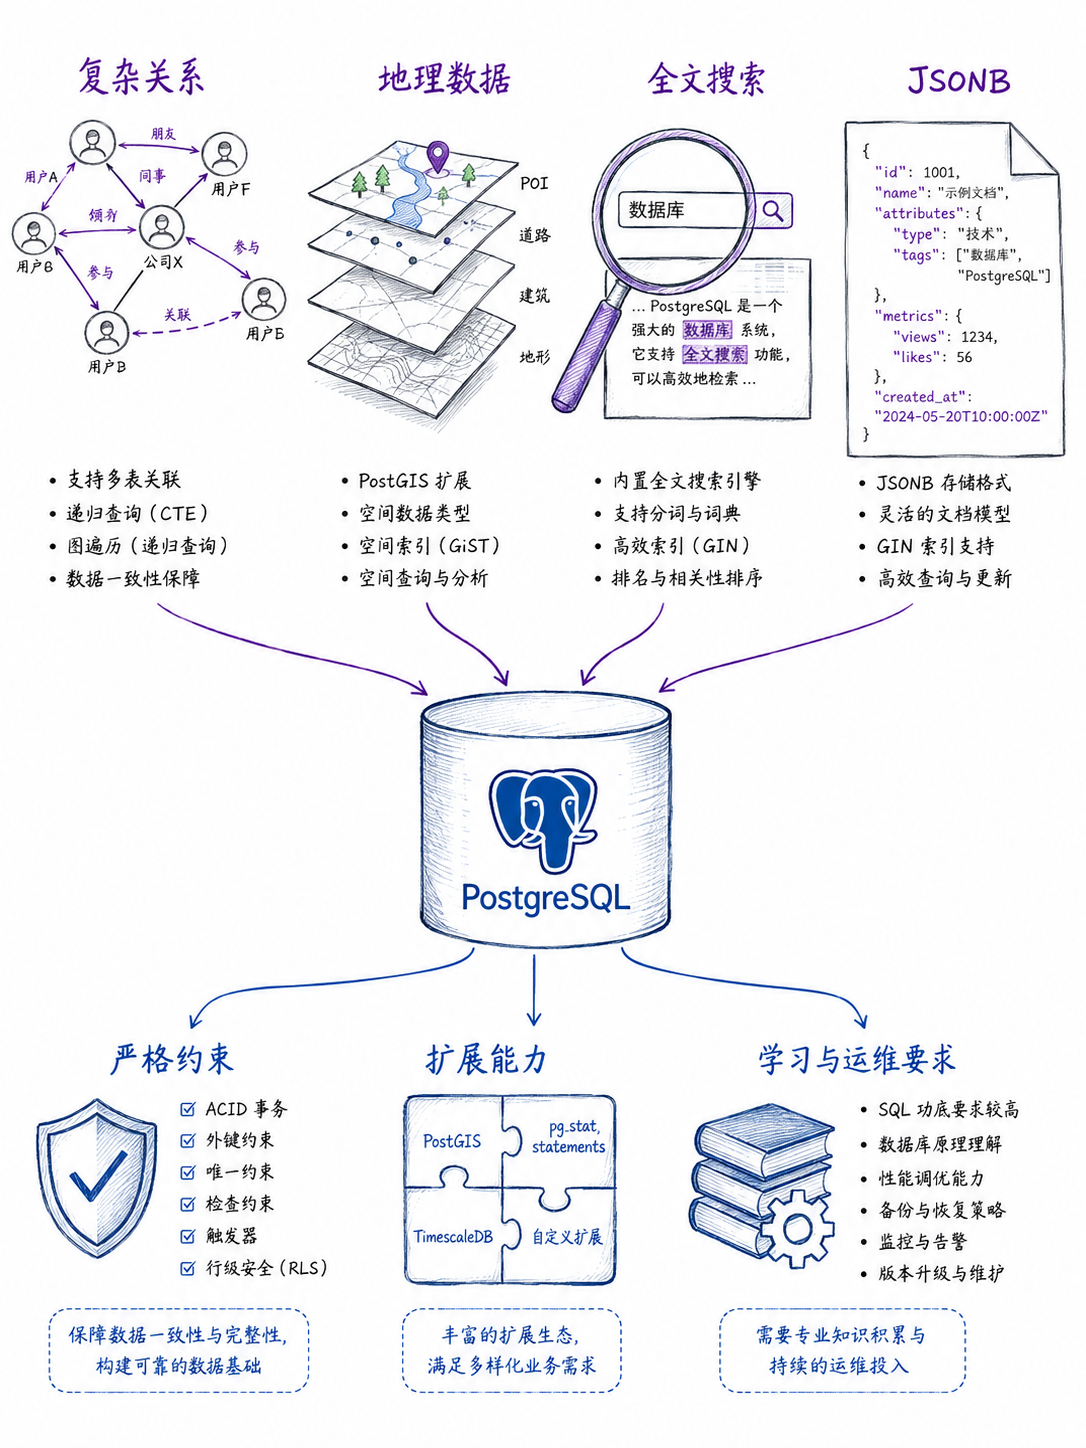
复杂关联、地理信息、全文检索或半结构化数据需求,是优先研究 PostgreSQL 的典型信号。
当业务规则需要被数据层更严格地表达,或者查询本身已经成为系统的核心能力时,PostgreSQL 的类型、约束和扩展能力更值得投入评估。选择它并不意味着可以跳过数据建模和性能验证;复杂系统反而更需要清晰的索引、查询计划和恢复策略。
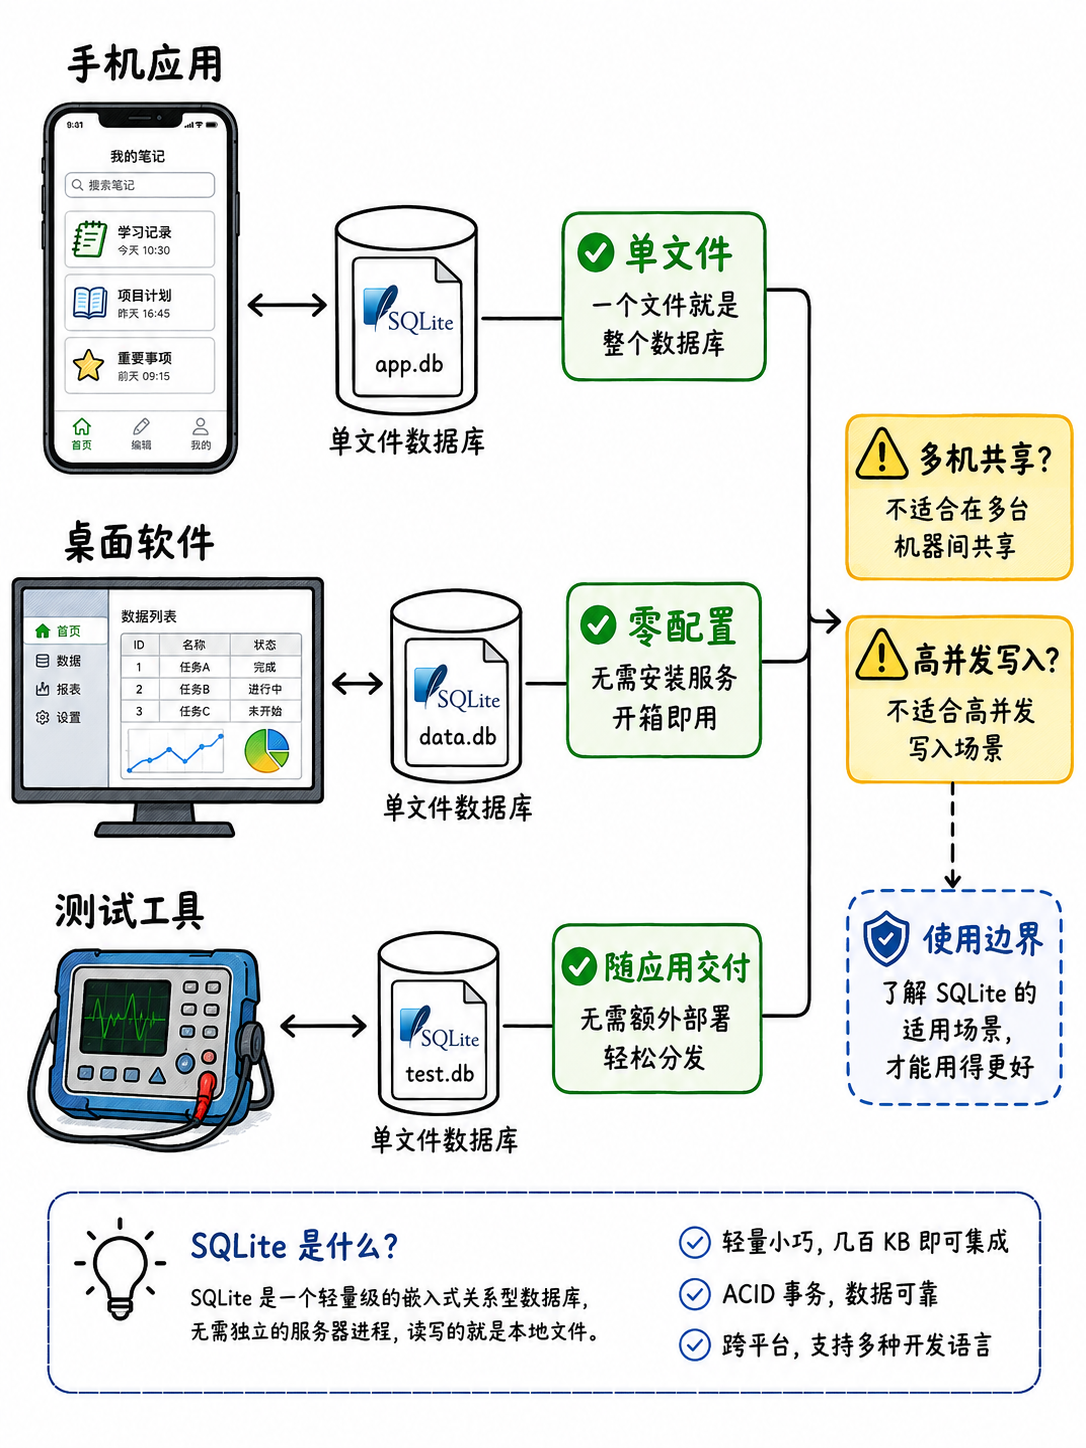
本地应用、测试工具和边缘设备若追求极简交付,SQLite 往往更匹配。
这里的核心优势是部署:不需要单独启动服务端进程,也不用为每个用户准备远程数据库实例。只要工作负载仍符合单文件、局部写入和本地嵌入的边界,SQLite 可以让产品显著减少部署与维护环节。
结论:从场景、复杂度和维护能力做决定
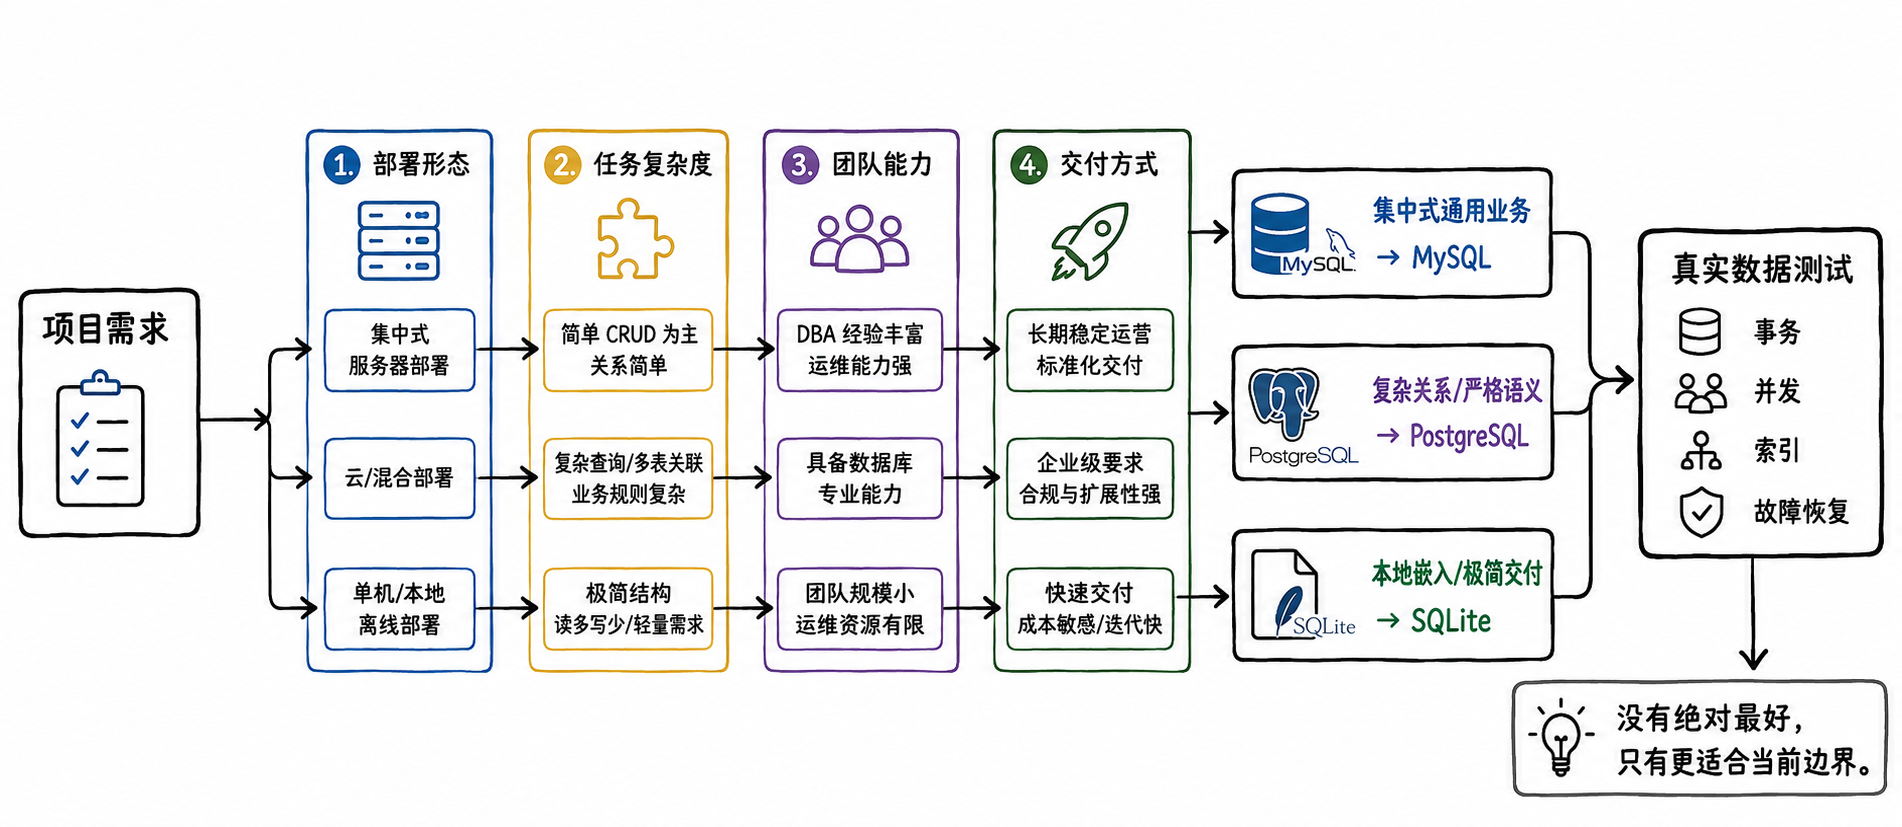
先判断系统边界,再判断数据复杂度和团队维护能力,才能得到可执行的数据库选择。
可以用三句话作为初筛:集中式通用业务优先评估 MySQL;复杂关系和严格数据语义优先评估 PostgreSQL;本地嵌入和极简交付优先评估 SQLite。最后必须回到真实数据、真实事务、并发写入、索引效果与故障恢复演练。没有脱离项目规模、任务边界和团队能力的“最好数据库”。
参考资料
📌 查阅提示:点击下方超链接可直接复制对应网址,粘贴至手机或电脑浏览器中即可查阅官方完整技术文档与规范。
【官方资料】PostgreSQL:About
说明:官方权威技术规范与开发者实现参考手册。【官方资料】PostgreSQL:Data Types
说明:官方权威技术规范与开发者实现参考手册。【官方资料】MySQL:InnoDB Transaction Model
说明:官方权威技术规范与开发者实现参考手册。【官方资料】MySQL:InnoDB Recovery
说明:官方权威技术规范与开发者实现参考手册。【官方资料】SQLite:About
说明:官方权威技术规范与开发者实现参考手册。【官方资料】SQLite:Transactions
说明:官方权威技术规范与开发者实现参考手册。