爬虫是什么?库怎么选?
对应短视频主题:爬虫是什么?库怎么选?
资料核验与更新:2026-09-12
用黑板图解方式,简明讲解《爬虫是什么?库怎么选?》。
阅读边界
本文依据原始课程的研究笔记、课程结构和发布文案整理。涉及产品、模型、版本、平台规则、价格或资格等可能变化的信息,实践前应以当前官方资料和实际环境为准。
爬虫是什么?Python 的爬虫库怎么选?
爬虫是什么?Python 库怎么选?
先把网页想成一座有目录的图书馆。爬虫就是按规则自动取书、找信息、记下结果的程序。
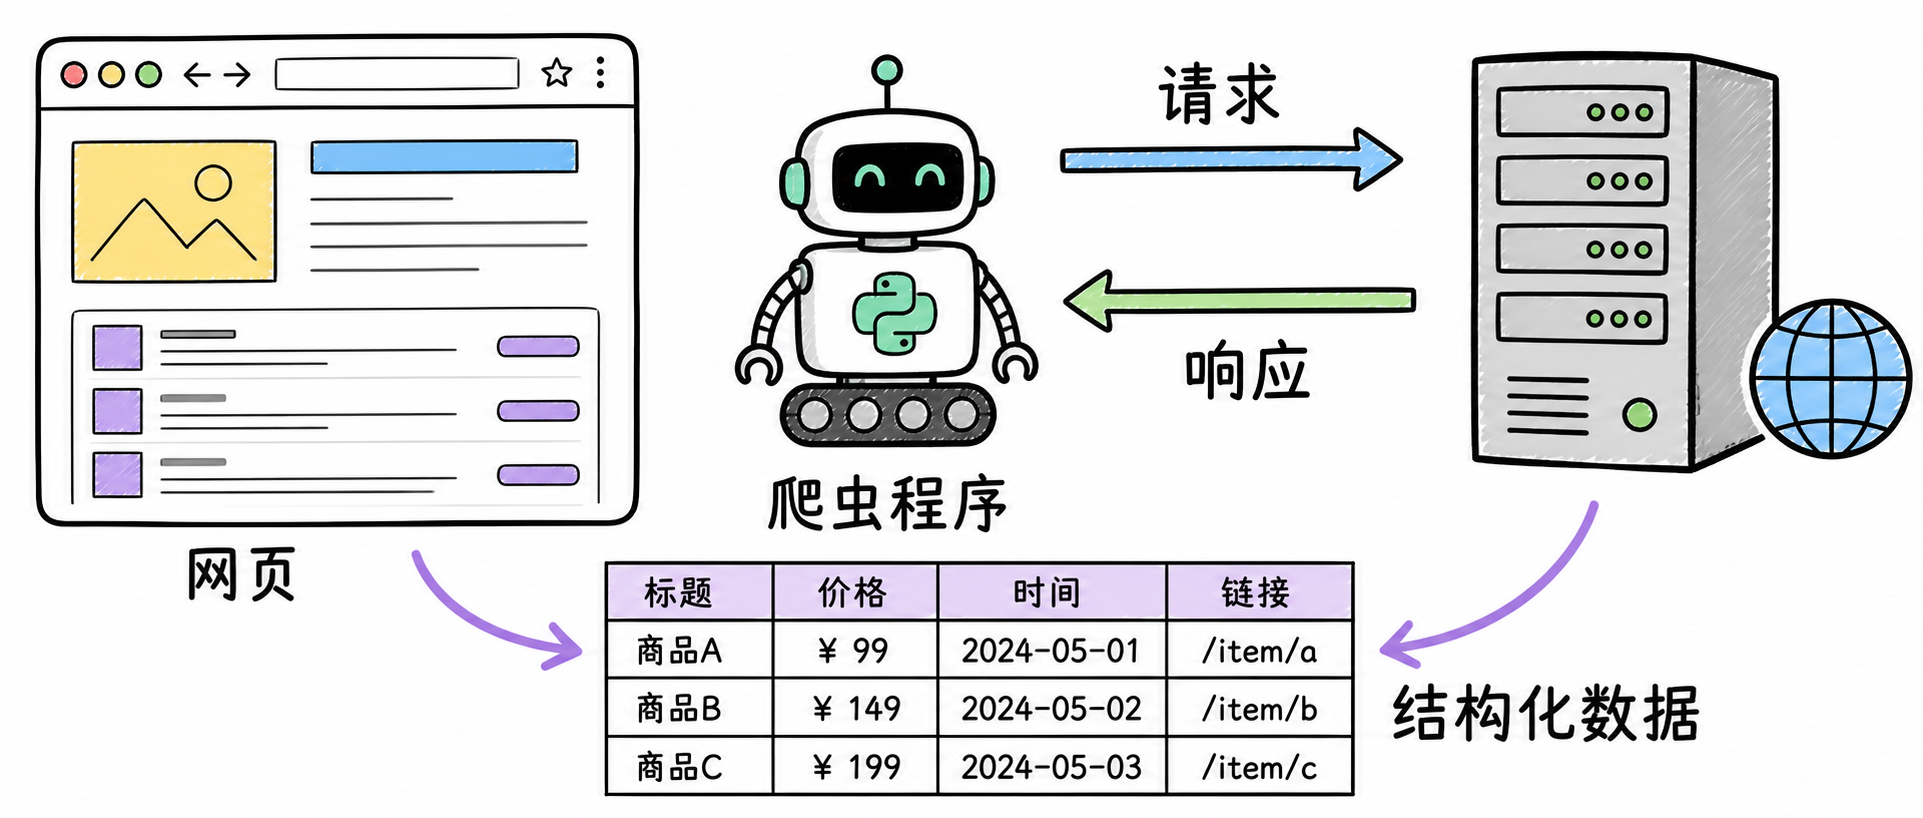
图解:Python 爬虫全景:从网络请求、DOM 解析到动态渲染与合规抓取的技术版图。
爬虫不是“读心术”
从请求到字段
它先发 HTTP 请求,再接收服务器返回的响应。网页内容通常是 HTML,程序要从这棵标签树里找到需要的字段。
页面里的链接,还能把它带到下一页。
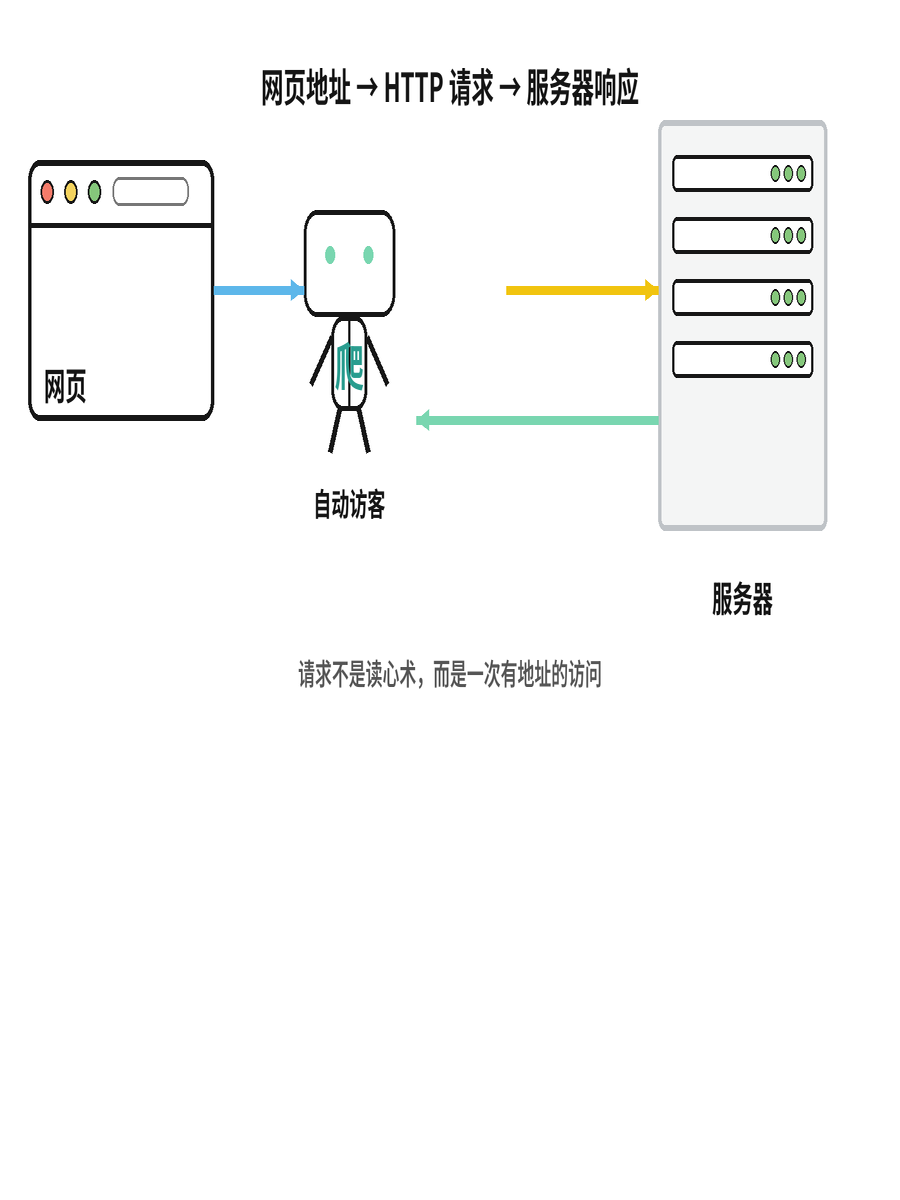
图解:HTTP 请求的本质:构建请求头、携带 Cookie、处理状态码与重定向。
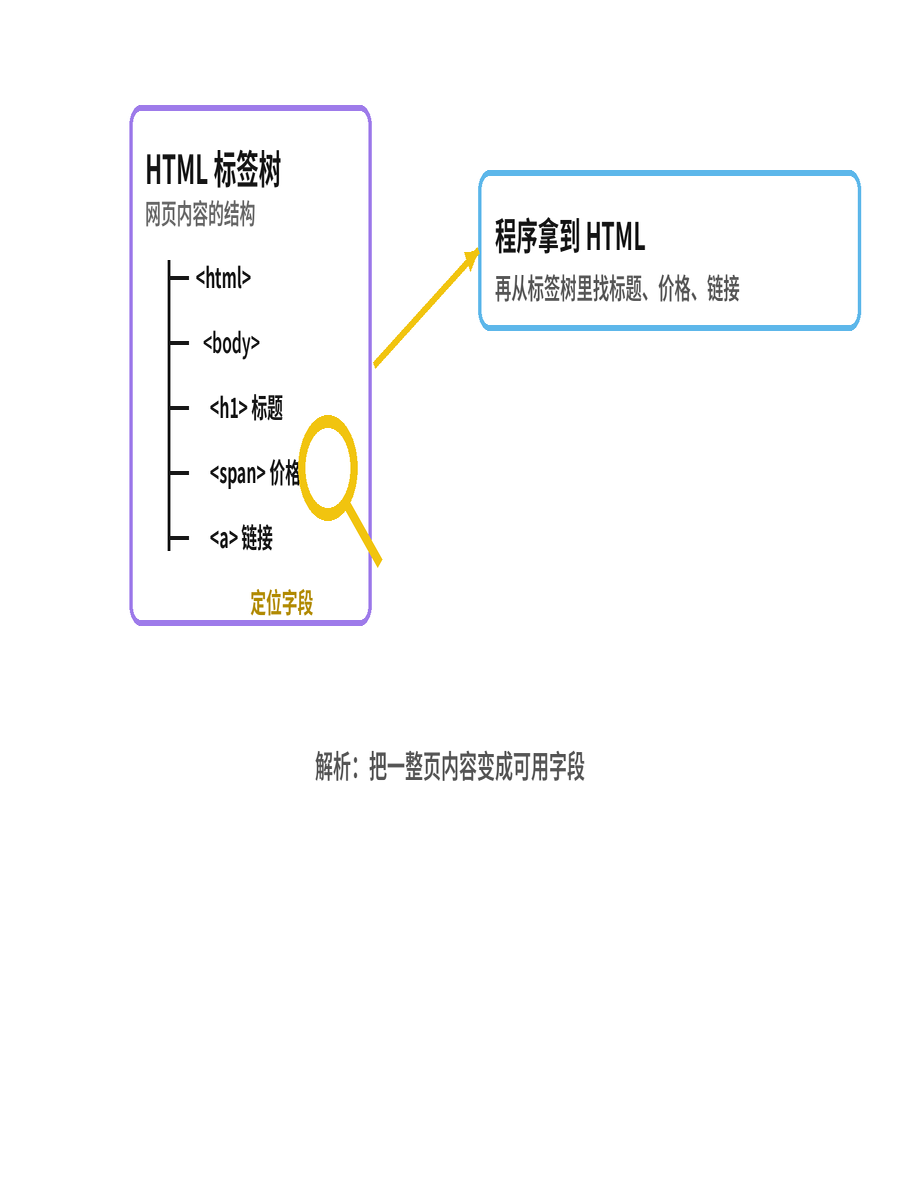
图解:数据解析与抽取:从原始 HTML/JSON 中定位标签、提取属性与结构化清洗。
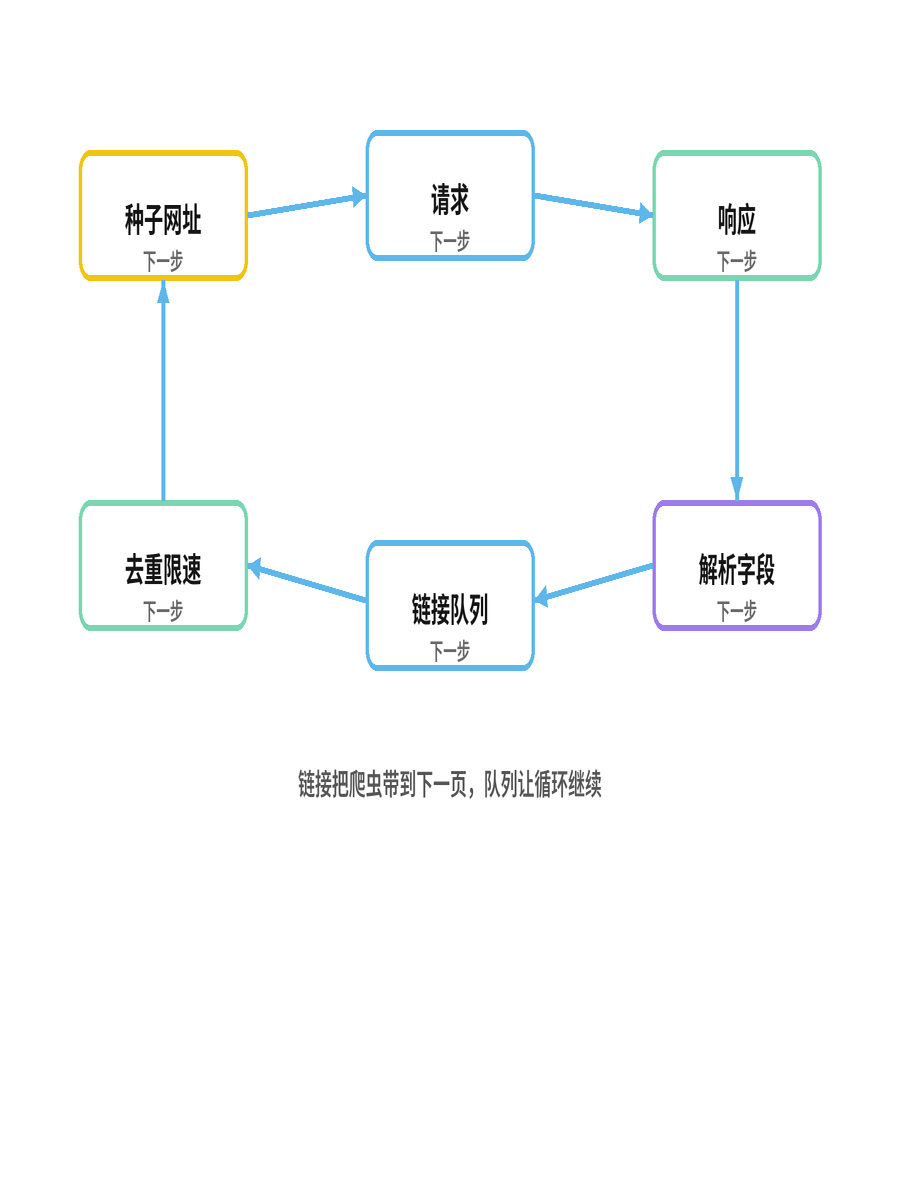
图解:爬虫核心循环流:URL 队列管理、请求分发、内容解析、数据持久化与去重。
三种轻量工具
Python 先学这三种库
urllib 是 Python 自带的标准库,适合简单请求。Requests 把 HTTP 写法变得更顺手。
Beautiful Soup 专门帮助你在 HTML 里定位和提取内容。
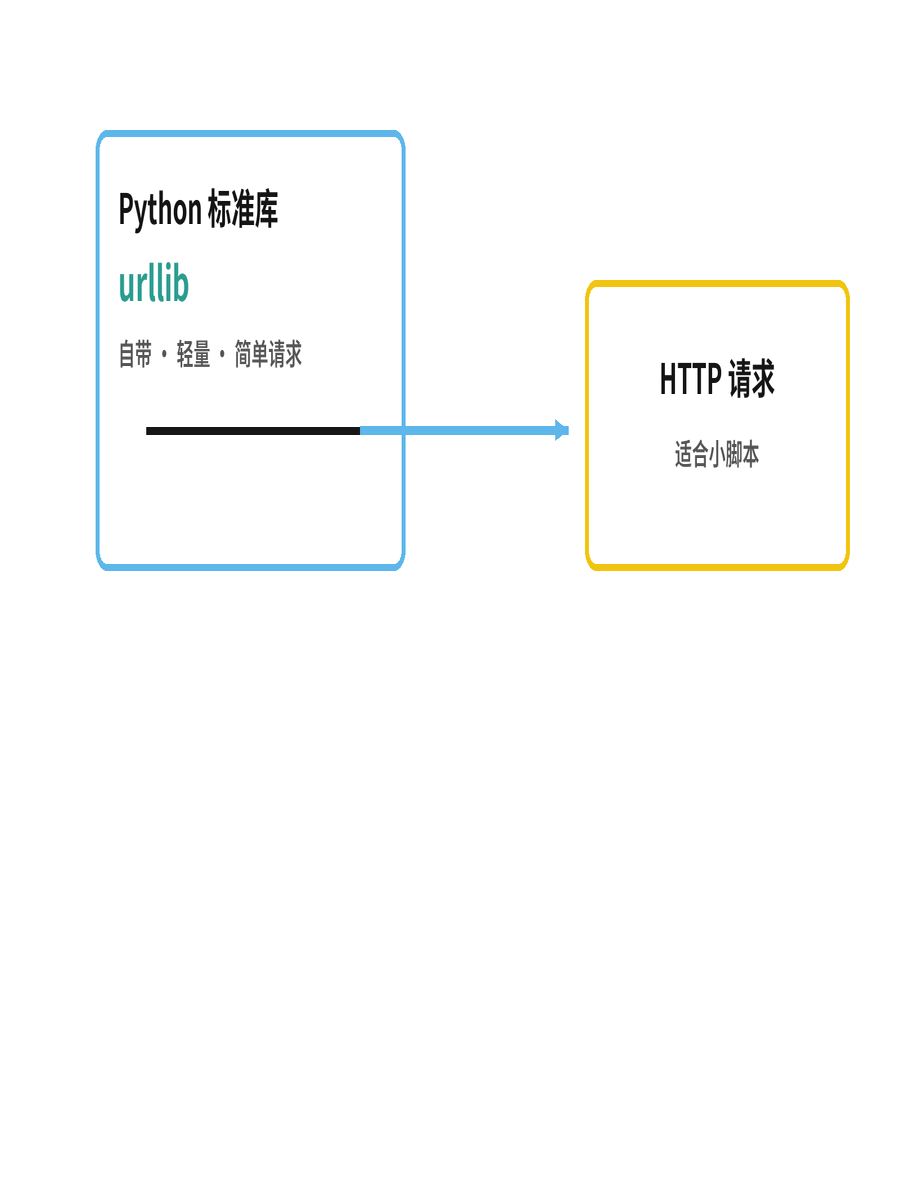
图解:标准库 urllib:Python 内置开箱即用,但接口较底层且缺乏高级易用特性。
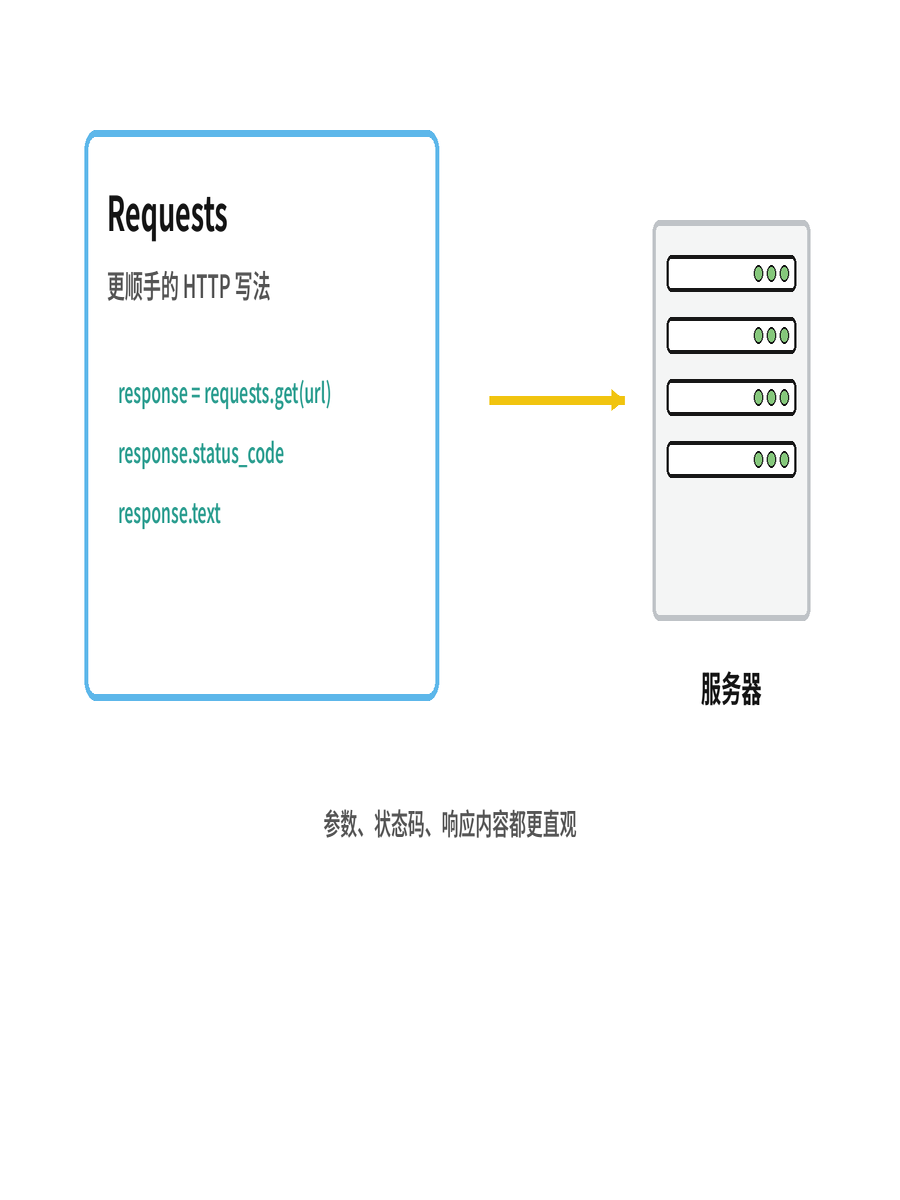
图解:Requests 与 HTTPX:优雅的人性化 API、会话持久化与现代异步并发支持。
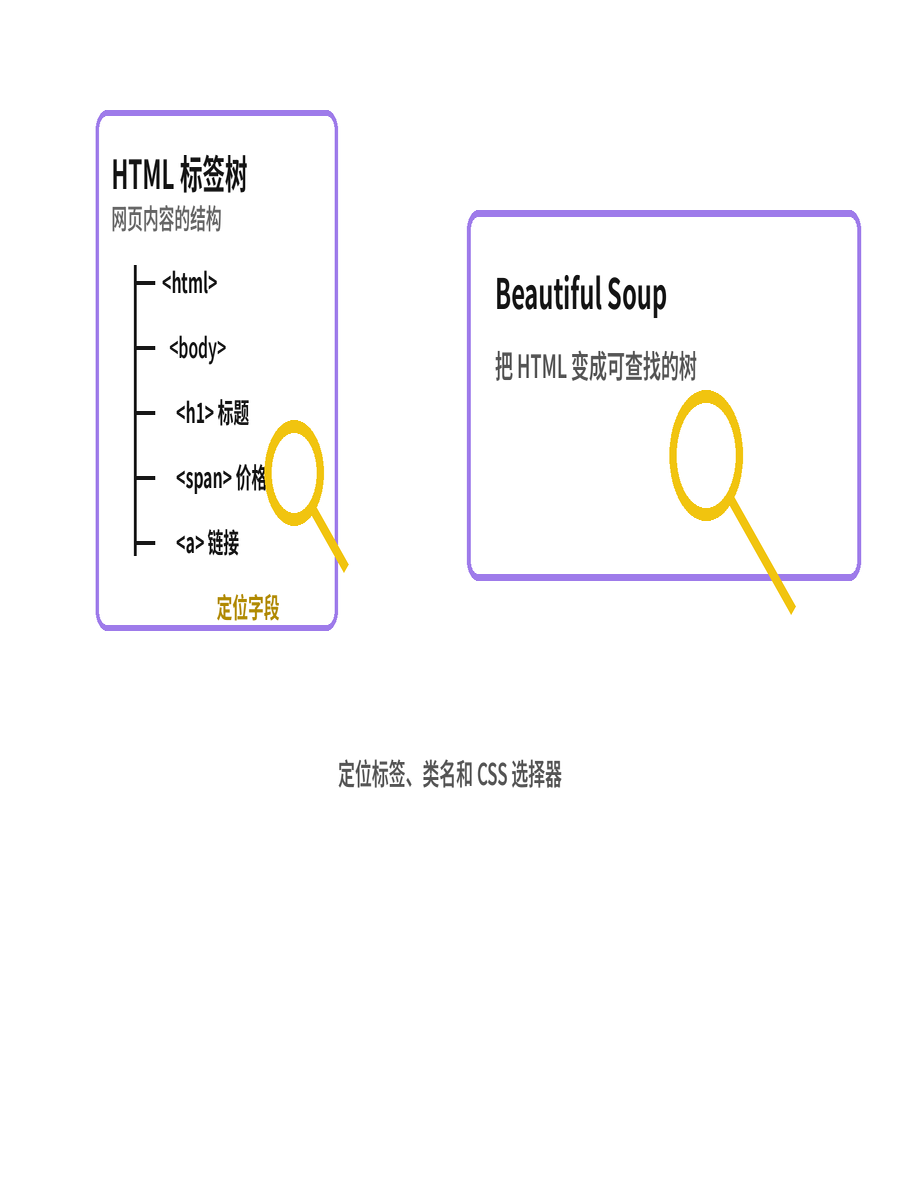
图解:BeautifulSoup 解析器:基于 DOM 树的直观定位与容错解析最佳选择。
页面一复杂,工具就升级
复杂页面怎么选库?
如果要抓很多页,Scrapy 会把调度、下载、解析和保存组织成流水线。如果页面必须执行 JavaScript,Selenium 会驱动真实浏览器。
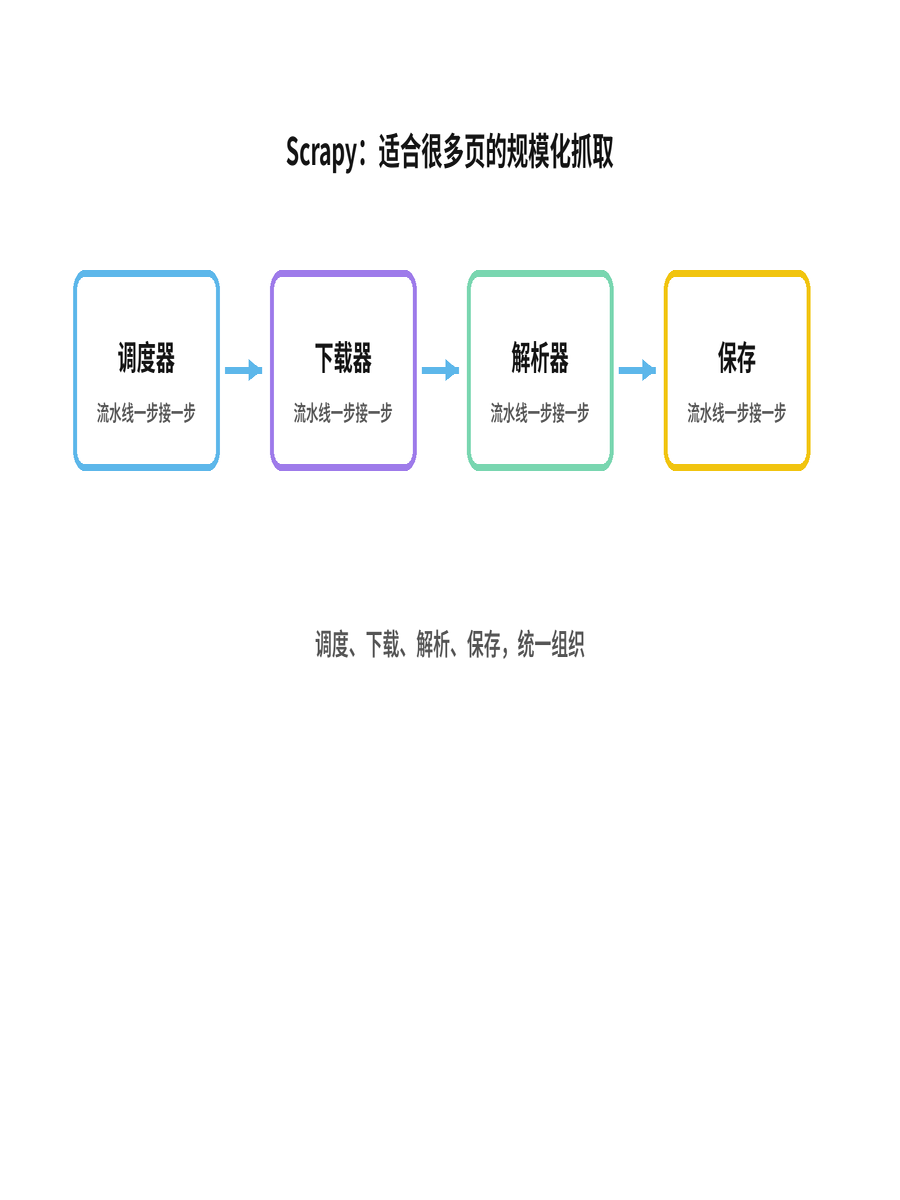
图解:Scrapy 工业级爬虫框架:集成 Twisted 异步引擎、中间件机制与管道数据流。
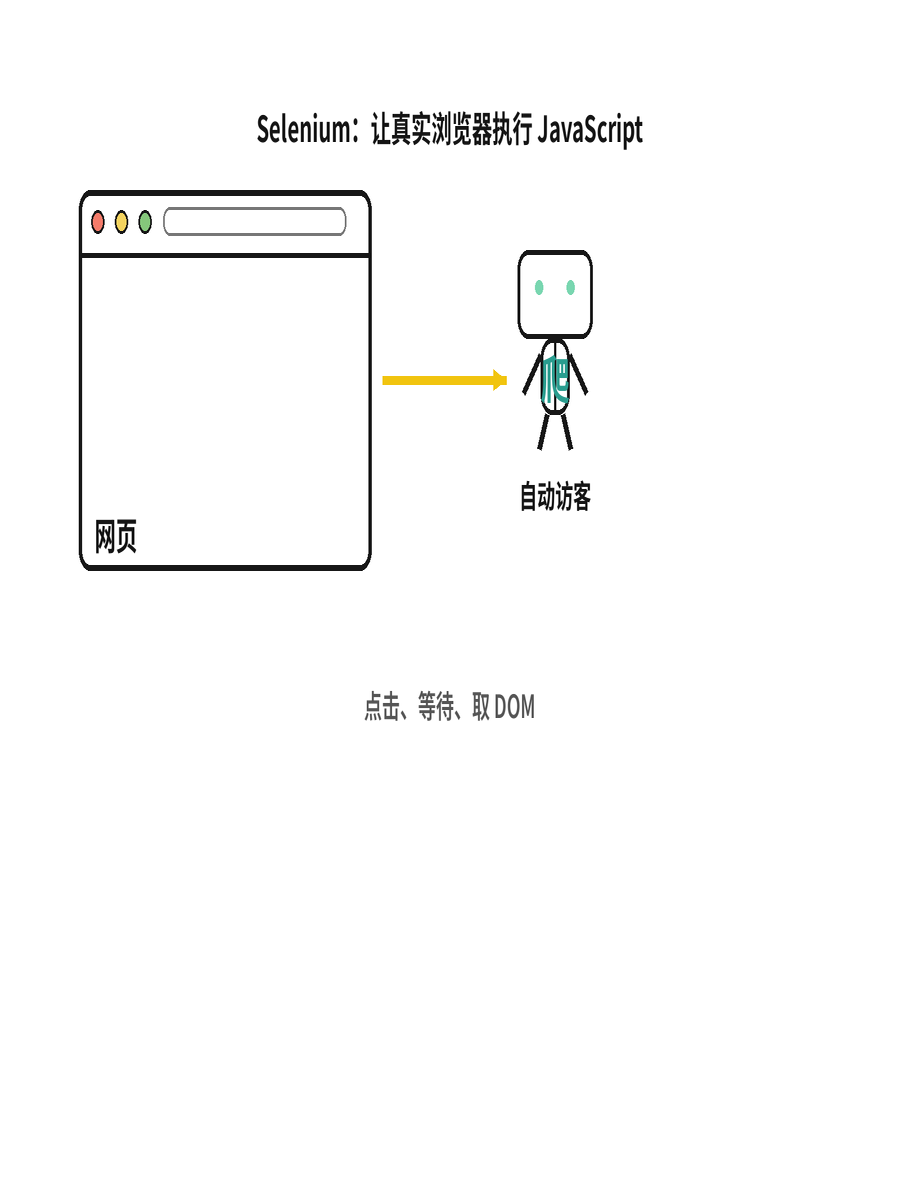
图解:Selenium 与 Playwright:无头浏览器驱动,彻底攻克现代 SPA 动态渲染页面。
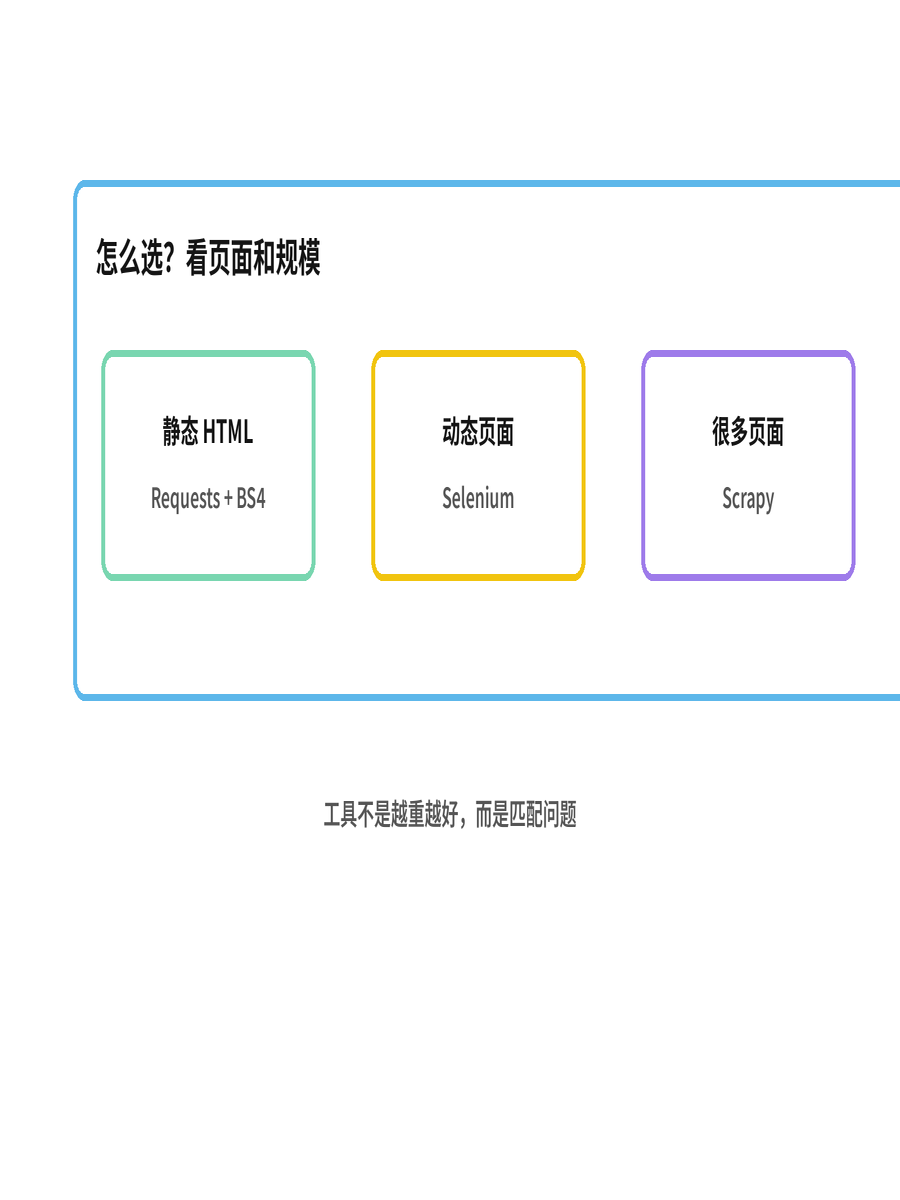
图解:Python 爬虫核心库能力对比表:在开发速度、运行性能与动态支持间权衡。
最后记住三件事
爬虫的边界与选择
能访问不代表可以随便抓。先看 robots.txt,再控制频率和超时,只取真正需要的数据。
把爬虫看成有礼貌的自动访客。
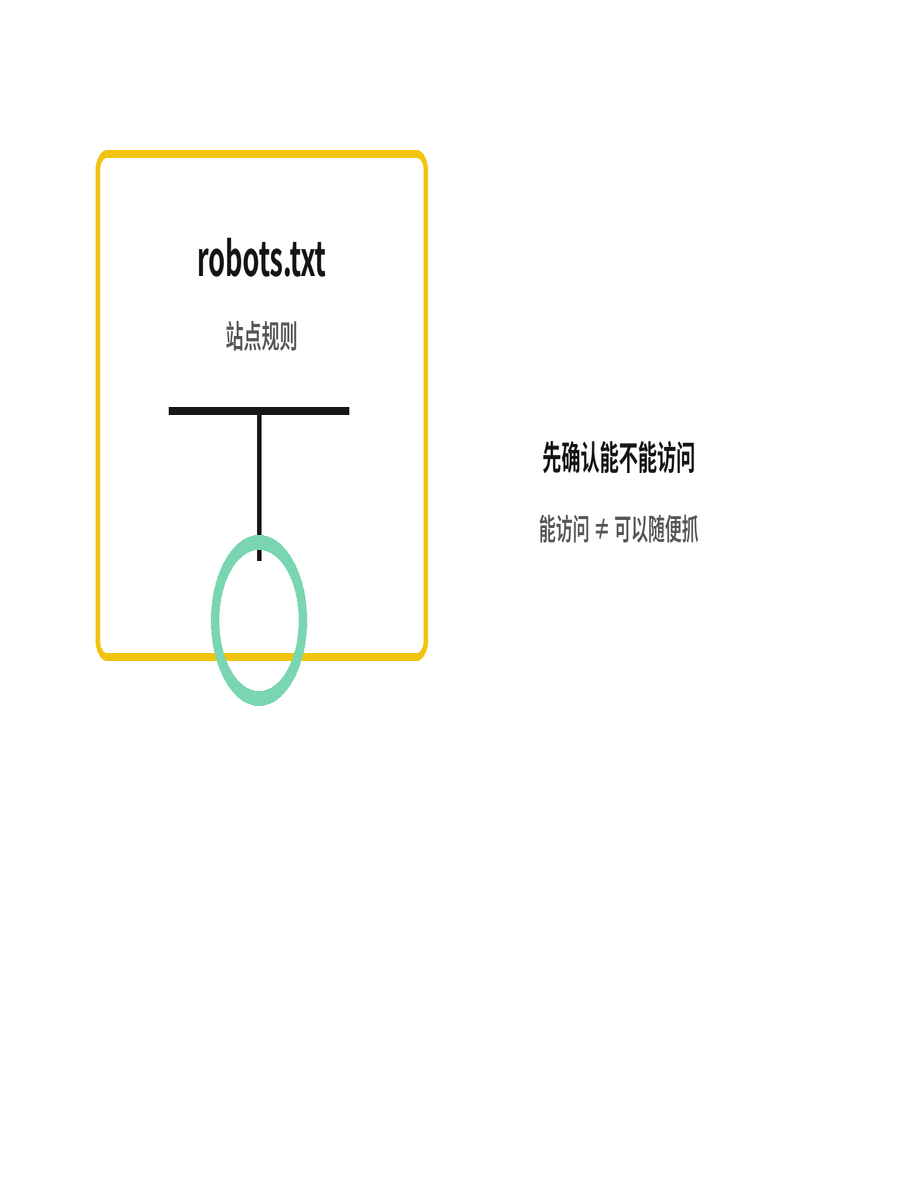
图解:爬虫道德与法律合规边界:遵守 Robots 协议、严格控制请求速率、保护数据隐私。
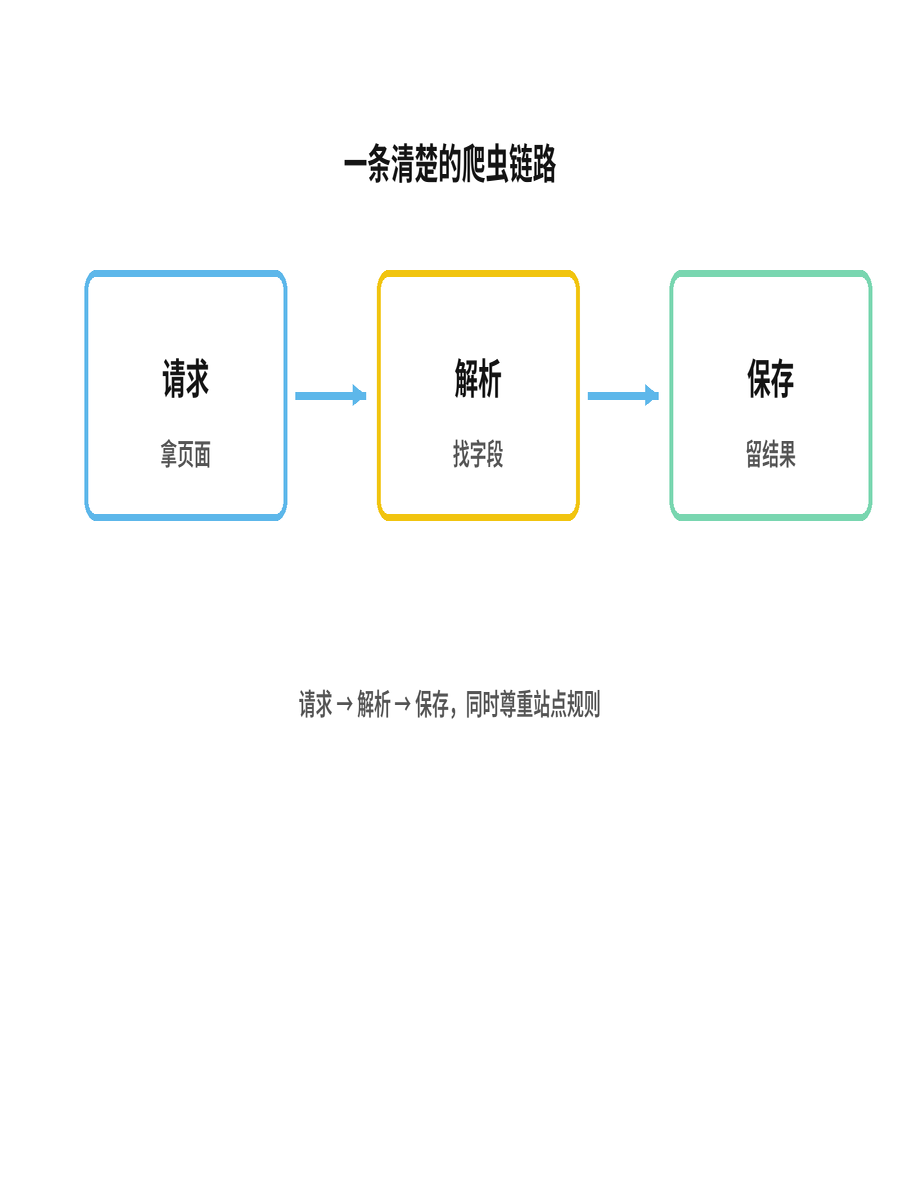
图解:爬虫技术选型决策总结:按目标网站类型(静态/接口/动态)与规模合理选型。
小结
把问题拆成目标、约束、证据和验证四部分,通常比直接寻找唯一答案更可靠。先用本文的框架完成一次小范围验证,再根据真实反馈调整下一步。
参考资料
📌 查阅提示:点击下方超链接可直接复制对应网址,粘贴至手机或电脑浏览器中即可查阅官方完整技术文档与规范。
【维基百科】网络爬虫(Web Crawler)工作原理与技术分类
说明:网络机器人、搜索引擎抓取与自动化数据提取的基础架构与伦理标准。【MDN 权威教程】HTTP 协议总览与请求/响应报文解析
说明:从底层彻底理解 URL、HTTP 请求头(User-Agent、Cookie)、状态码与内容编码。【Python 官方文档】urllib.request 标准网络请求库规范
说明:Python 内置的轻量网络请求标准模块,开箱即用但缺乏高级易用会话管理。【Requests 官方文档】Requests: 让 HTTP 服务于人类的快速入门
说明:Python 生态使用最广的同步 HTTP 客户端,优雅简洁的 API 设计典范。【Beautiful Soup 官方手册】Beautiful Soup 4 容错 HTML/XML 解析库
说明:基于 DOM 树的直观节点导航、CSS 选择器与高容错脏 HTML 数据提取。【Scrapy 官方文档】Scrapy 工业级异步抓取框架架构剖析
说明:集成 Twisted 异步非阻塞引擎、下载器中间件与 Item Pipeline 的分布式爬虫框架。【Selenium 官方指南】Selenium WebDriver 浏览器自动化与动态渲染
说明:真实驱动 Chromium/Firefox 浏览器,应对 SPA 复杂 JavaScript 动态渲染与前端交互。【IETF RFC 9309】Robots 排除协议正式标准规范(Robots.txt)
说明:互联网工程任务组权威标准,规范爬虫访问频次限制与抓取道德法律边界。