AI 为什么进入三维世界?
对应短视频主题:AI 为什么进入三维世界?
资料核验与更新:2026-09-12
二维图像识别擅长回答“画面里有什么”;但机器人、自动驾驶和智能设备还必须回答“它在哪里、离我多远、是否被遮挡、下一步会发生什么,以及怎样安全行动”。这就是 AI 进入三维世界的原因:目标不是把画面做得更立体,而是建立能被感知、预测和验证的空间模型。
阅读边界
本文依据原始课程的研究笔记、课程结构和发布文案整理。涉及产品、模型、版本、平台规则、价格或资格等可能变化的信息,实践前应以当前官方资料和实际环境为准。
从识别物体,到理解空间与动作
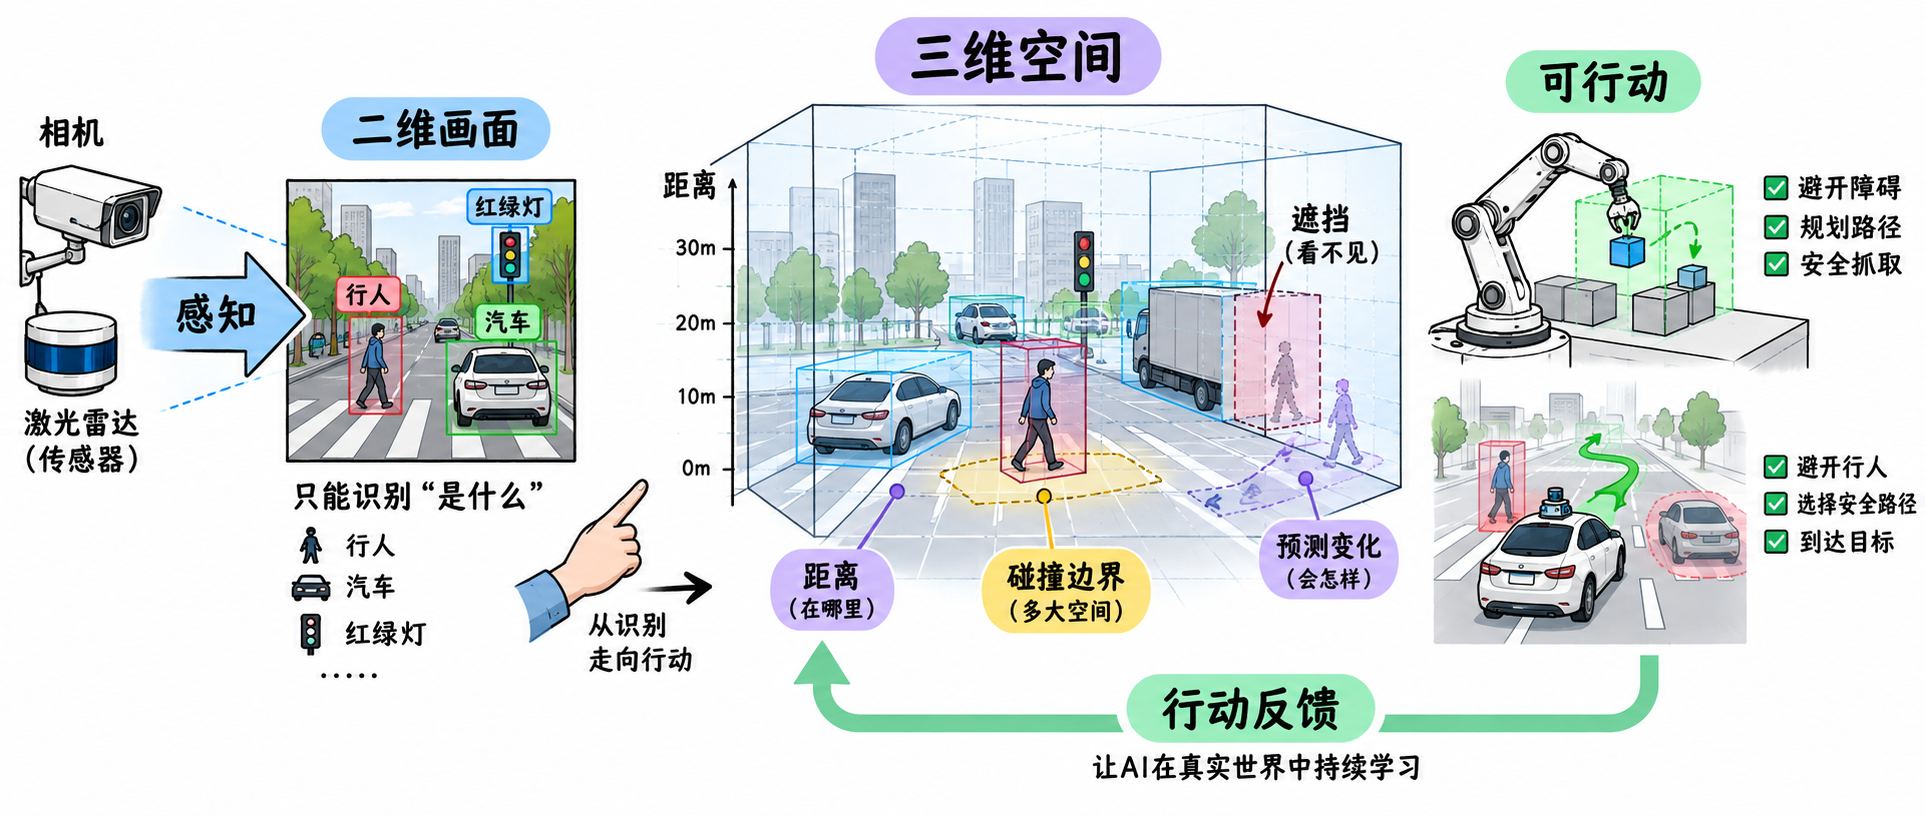
空间智能要求系统同时处理位置、距离、遮挡、可达性和动作后果。
当一个系统要抓取物体、驾驶车辆或避开行人时,仅知道“这里有杯子”并不足够;它还要判断杯子在何处、机械臂是否能够到、移动过程中会不会发生碰撞。这一层从感知到行动的连续判断,才是空间智能的核心。
三维技术如何走到今天
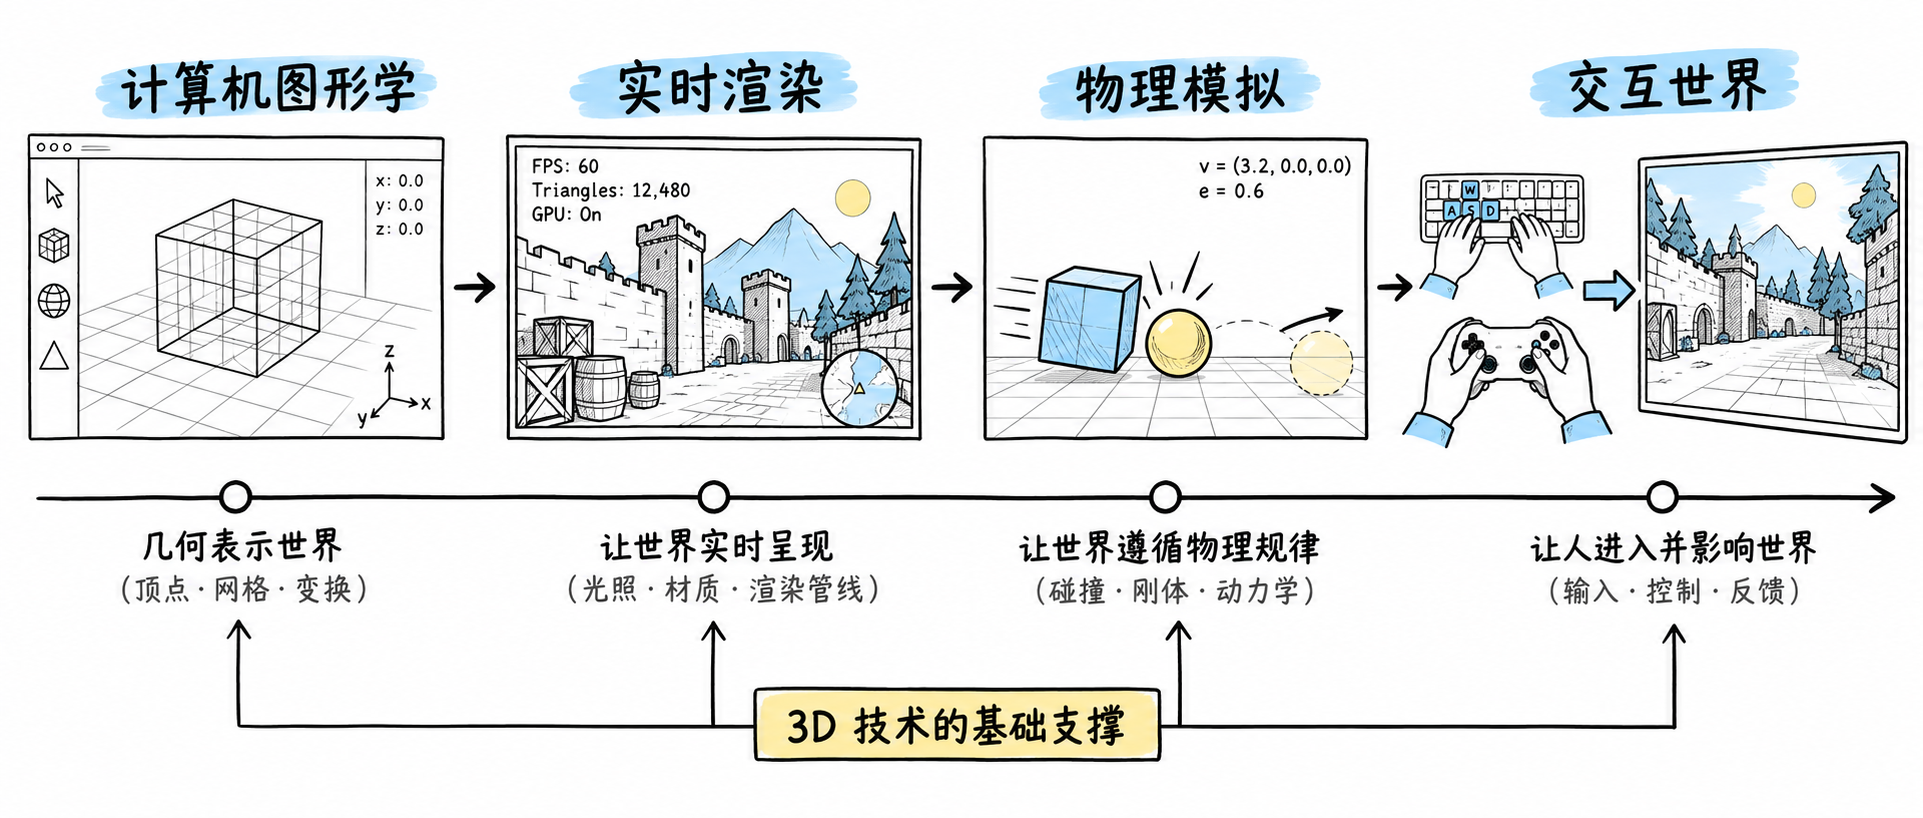
图形学和游戏引擎提供了创建、显示、模拟三维世界的基础。
三维并不是一项孤立技术。计算机图形学解决了如何表示和渲染对象,实时引擎让场景能够互动和模拟,传感器与算法再把现实世界的变化送回系统。
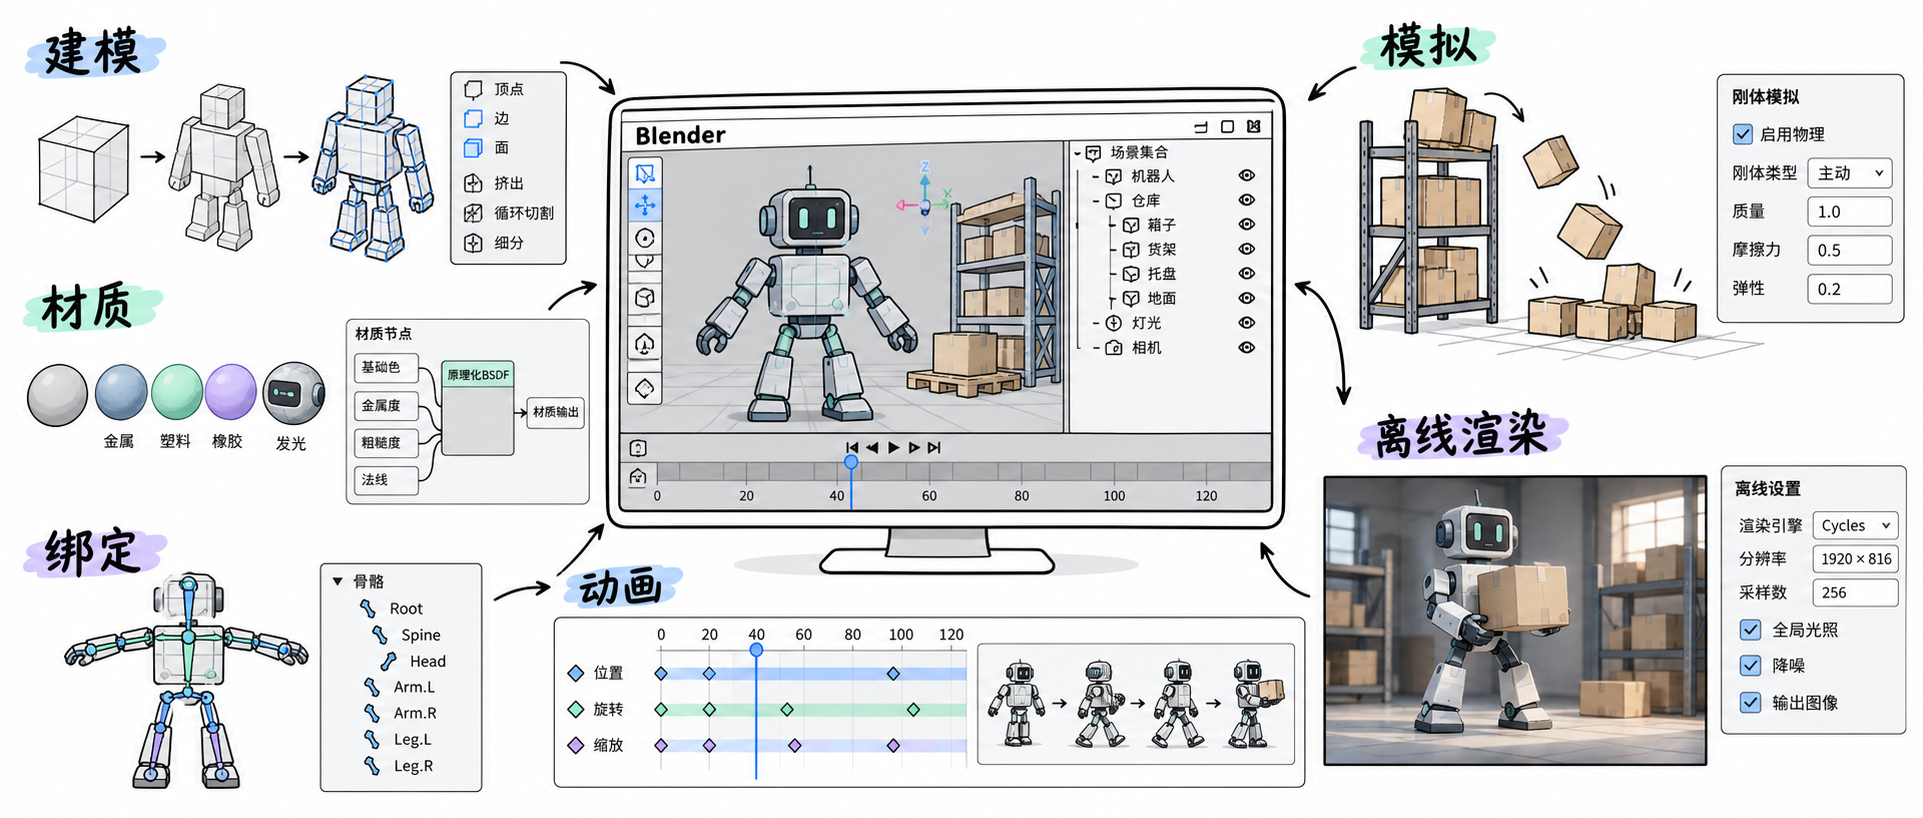
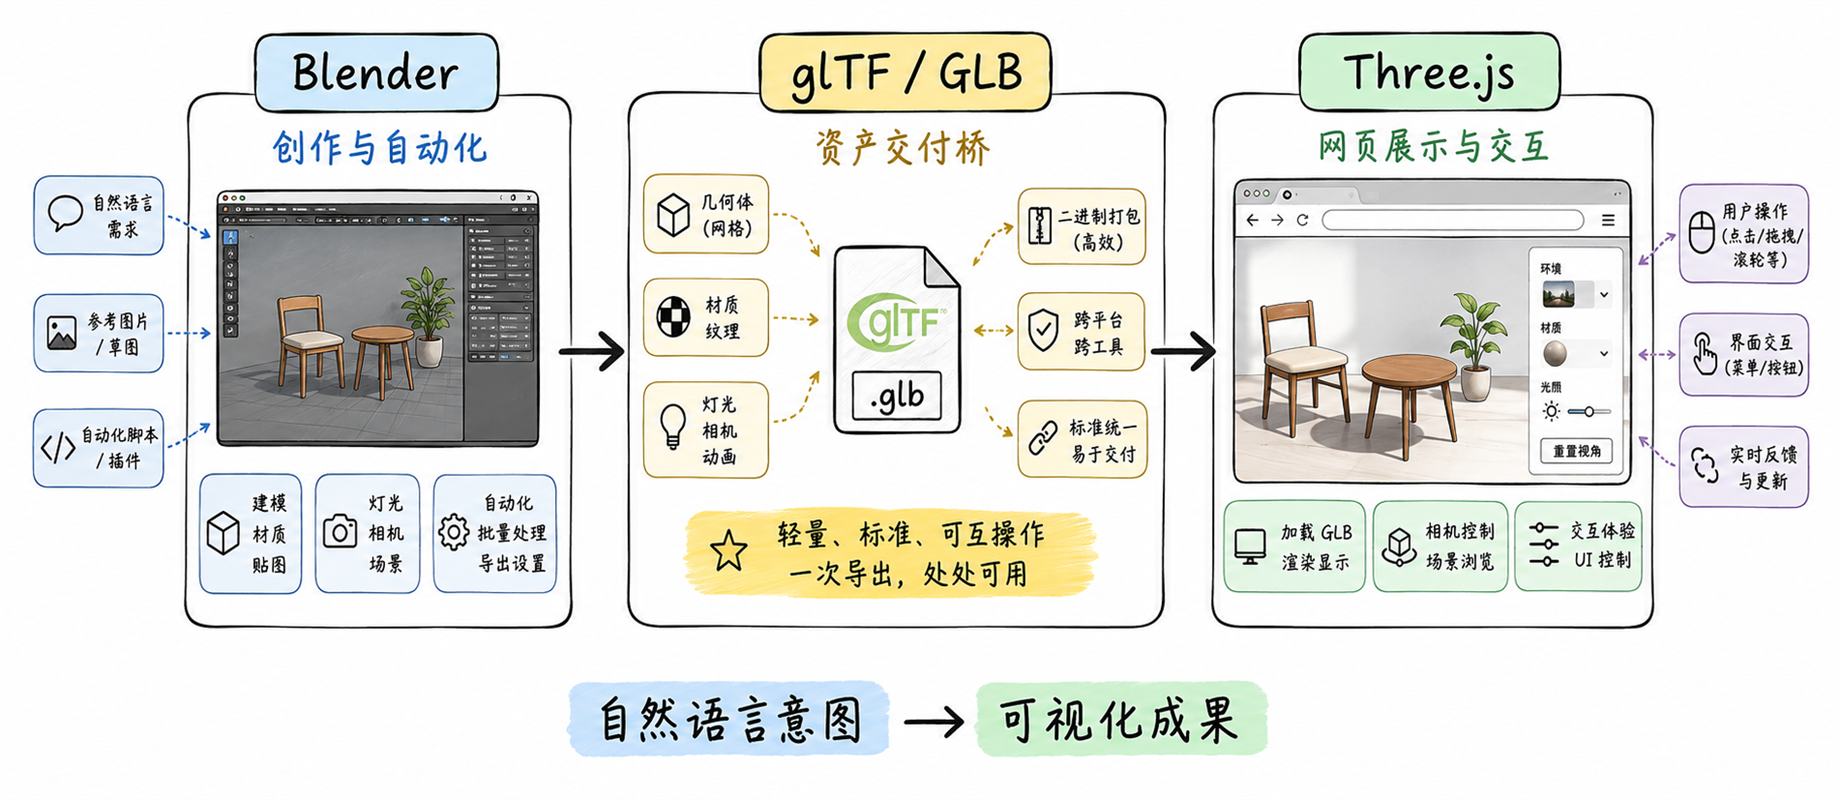
Blender 的角色是生产和编辑三维资产,而不是替代浏览器或仿真引擎。
一套可编辑的模型、材质和动画,是后续展示、训练和仿真的共同输入。Blender 适合承担这种资产生产工作:建模、绑定、动画、模拟和渲染可以在同一条创作流程中完成。
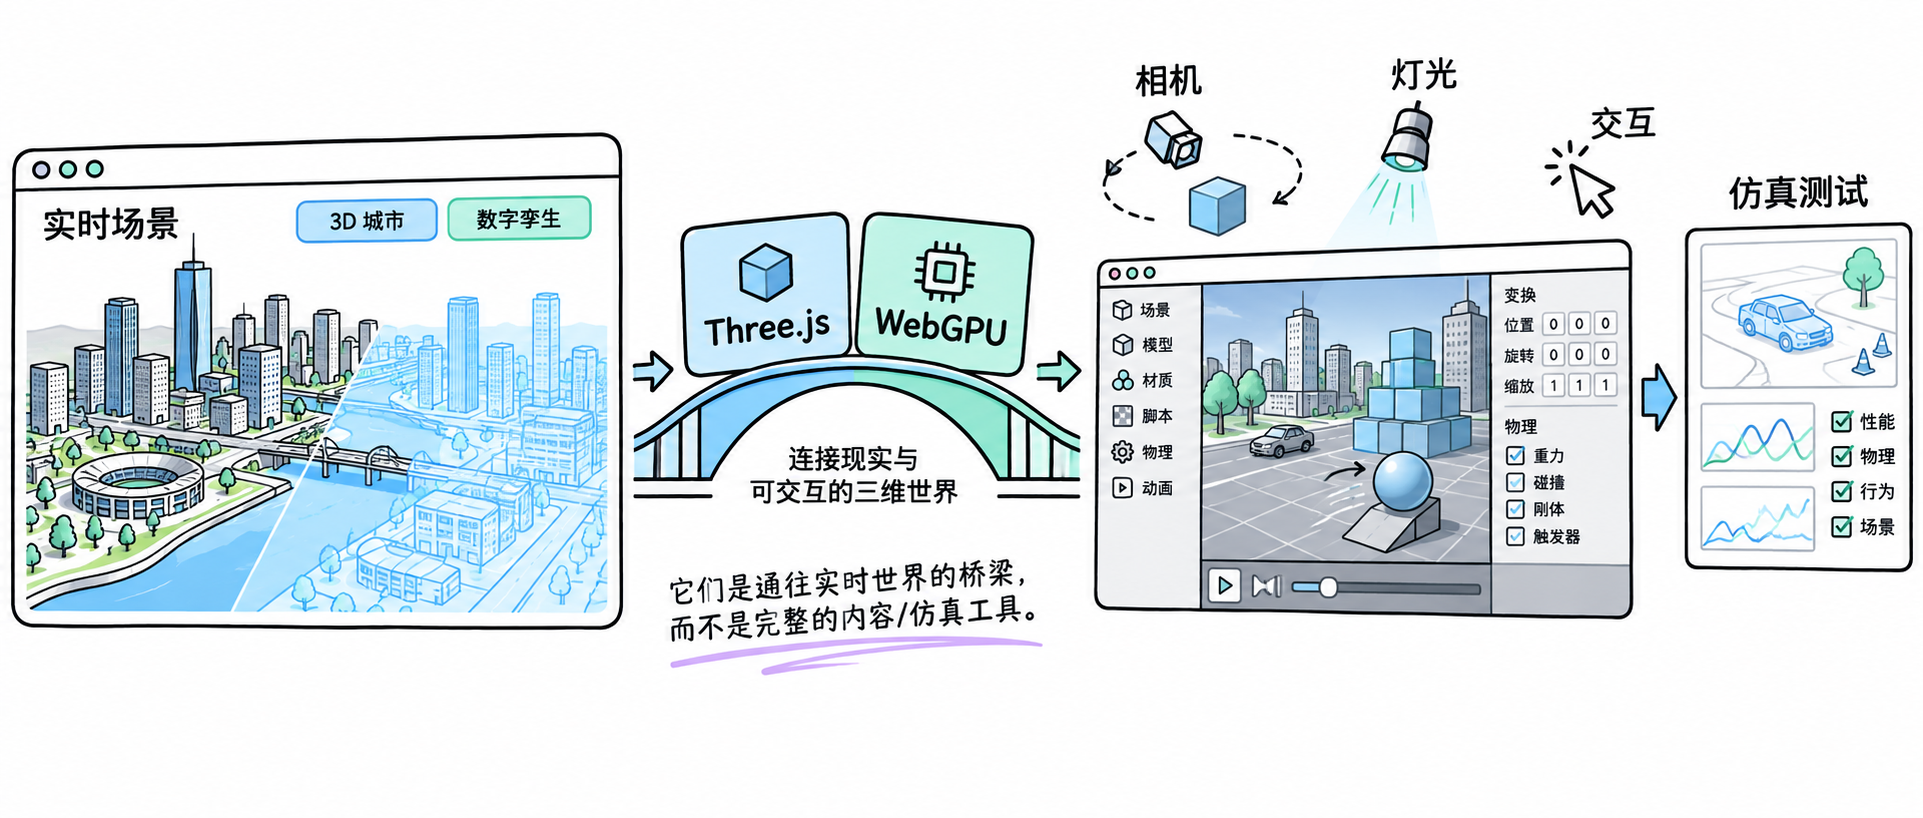
静态模型进入实时场景后,才可以接收交互、传感器和环境变化。
不同工具各自解决哪一层问题
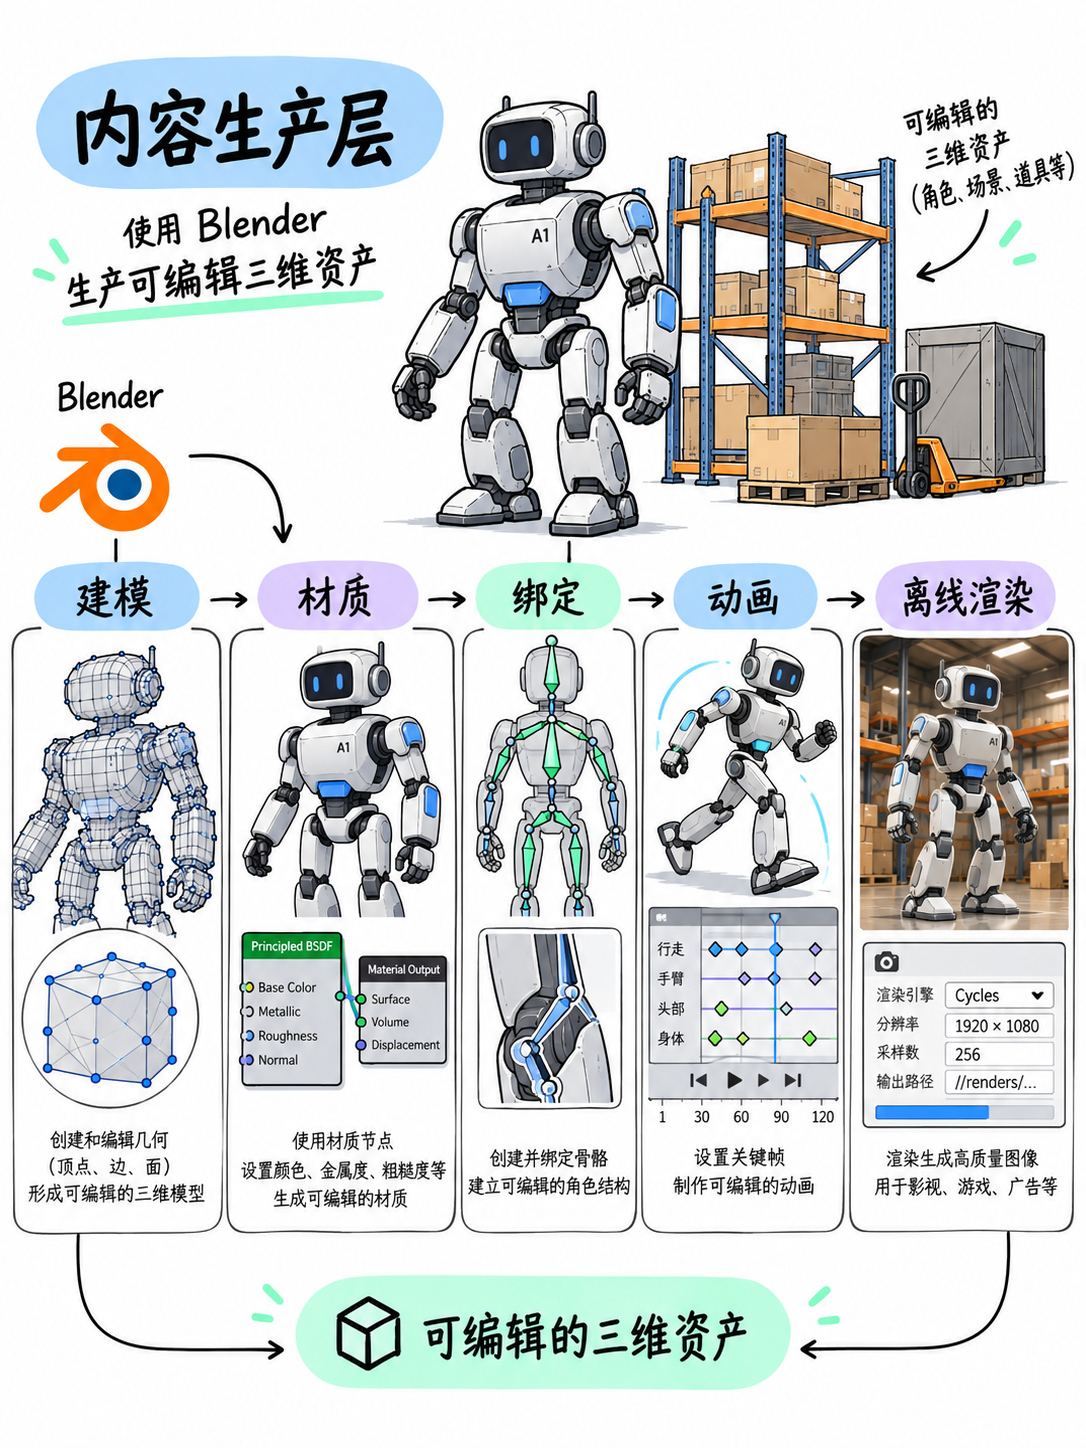
内容生产先解决“有什么模型可以使用”。
当成果需要在网页中交互展示,工具的角色会变化。
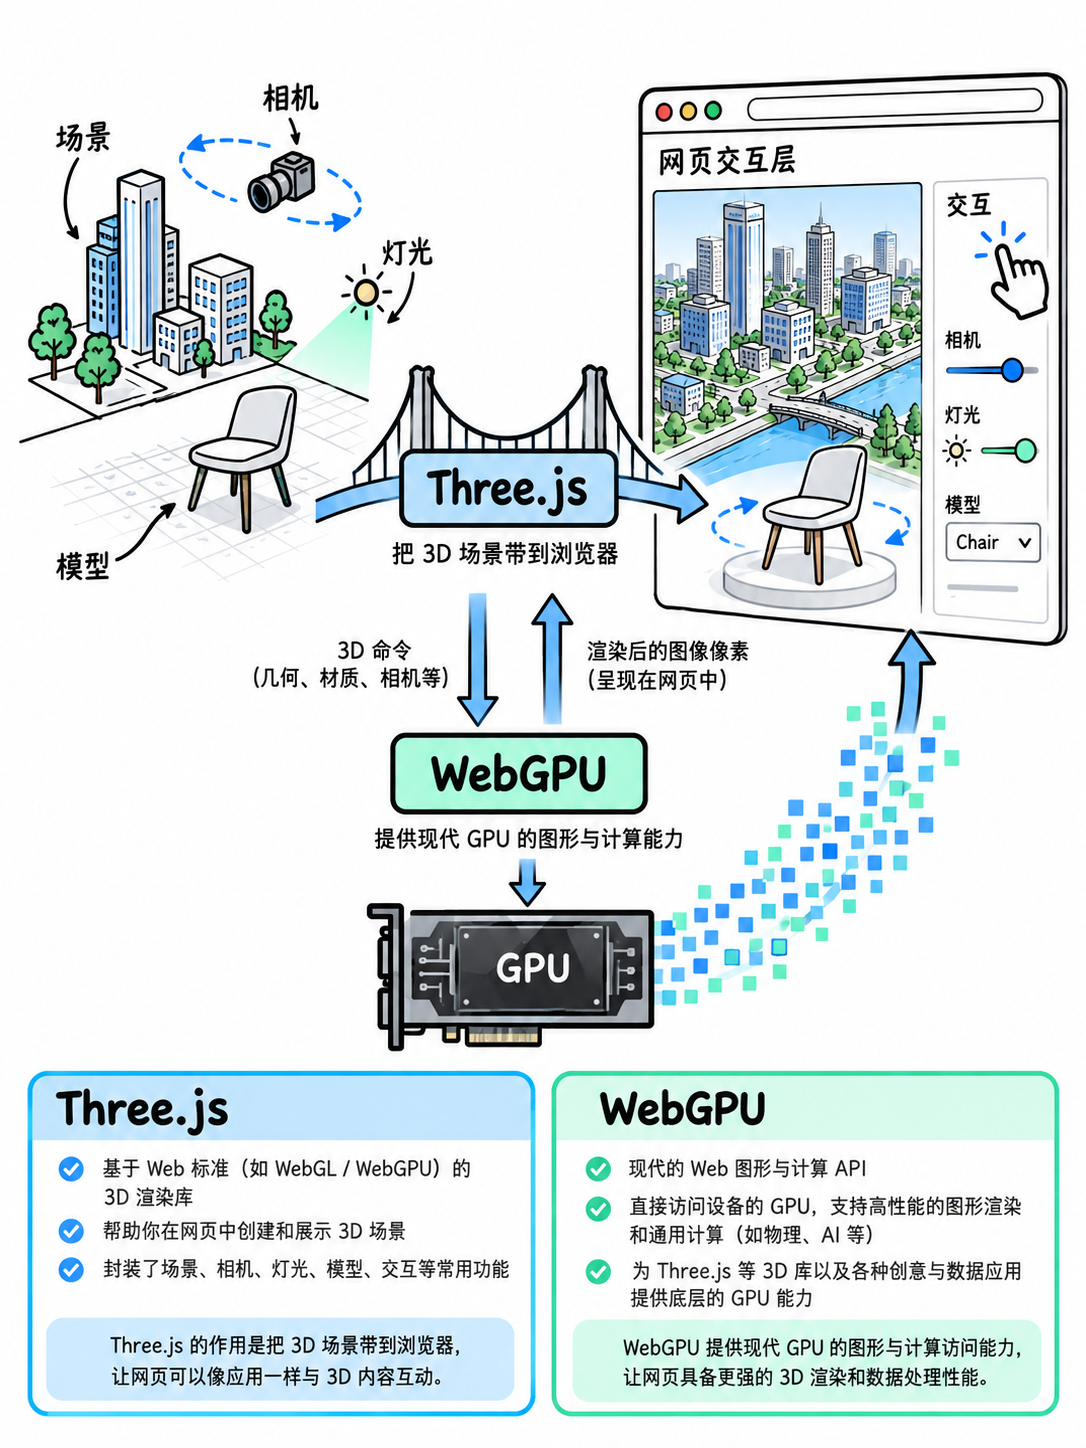
Three.js 用于组织浏览器内的场景和交互;WebGPU 是面向图形与计算的浏览器接口,并非替代关系。
Three.js 可以组织场景、相机、灯光、模型和用户交互,适合产品展示、数据可视化和数字孪生前端。WebGPU 则是浏览器对现代图形与计算能力的接口;它服务于底层能力,不等同于一个完整三维创作工具。
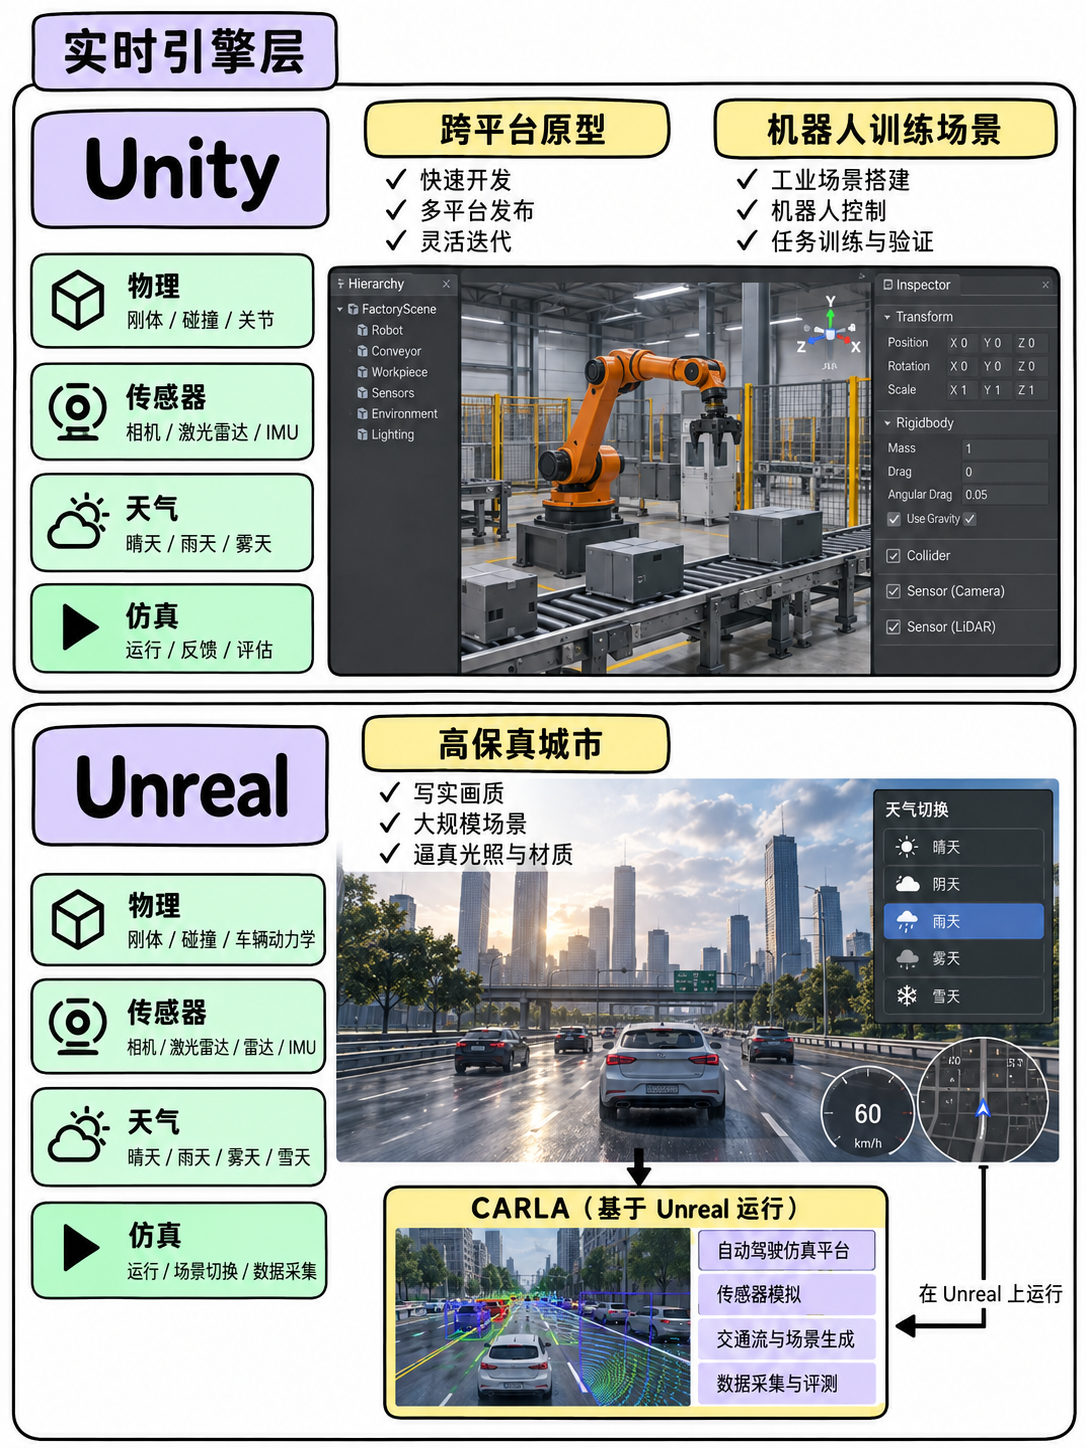
实时引擎负责可交互环境;CARLA 建立在 Unreal 之上,用于自动驾驶仿真。
Unity 常被用于跨平台原型、机器人训练和合成数据;Unreal 擅长高保真环境;CARLA 则把 Unreal 场景用于自动驾驶研究。它们的差异是任务分工,而不是统一的优劣排名。
为什么仿真和合成数据重要
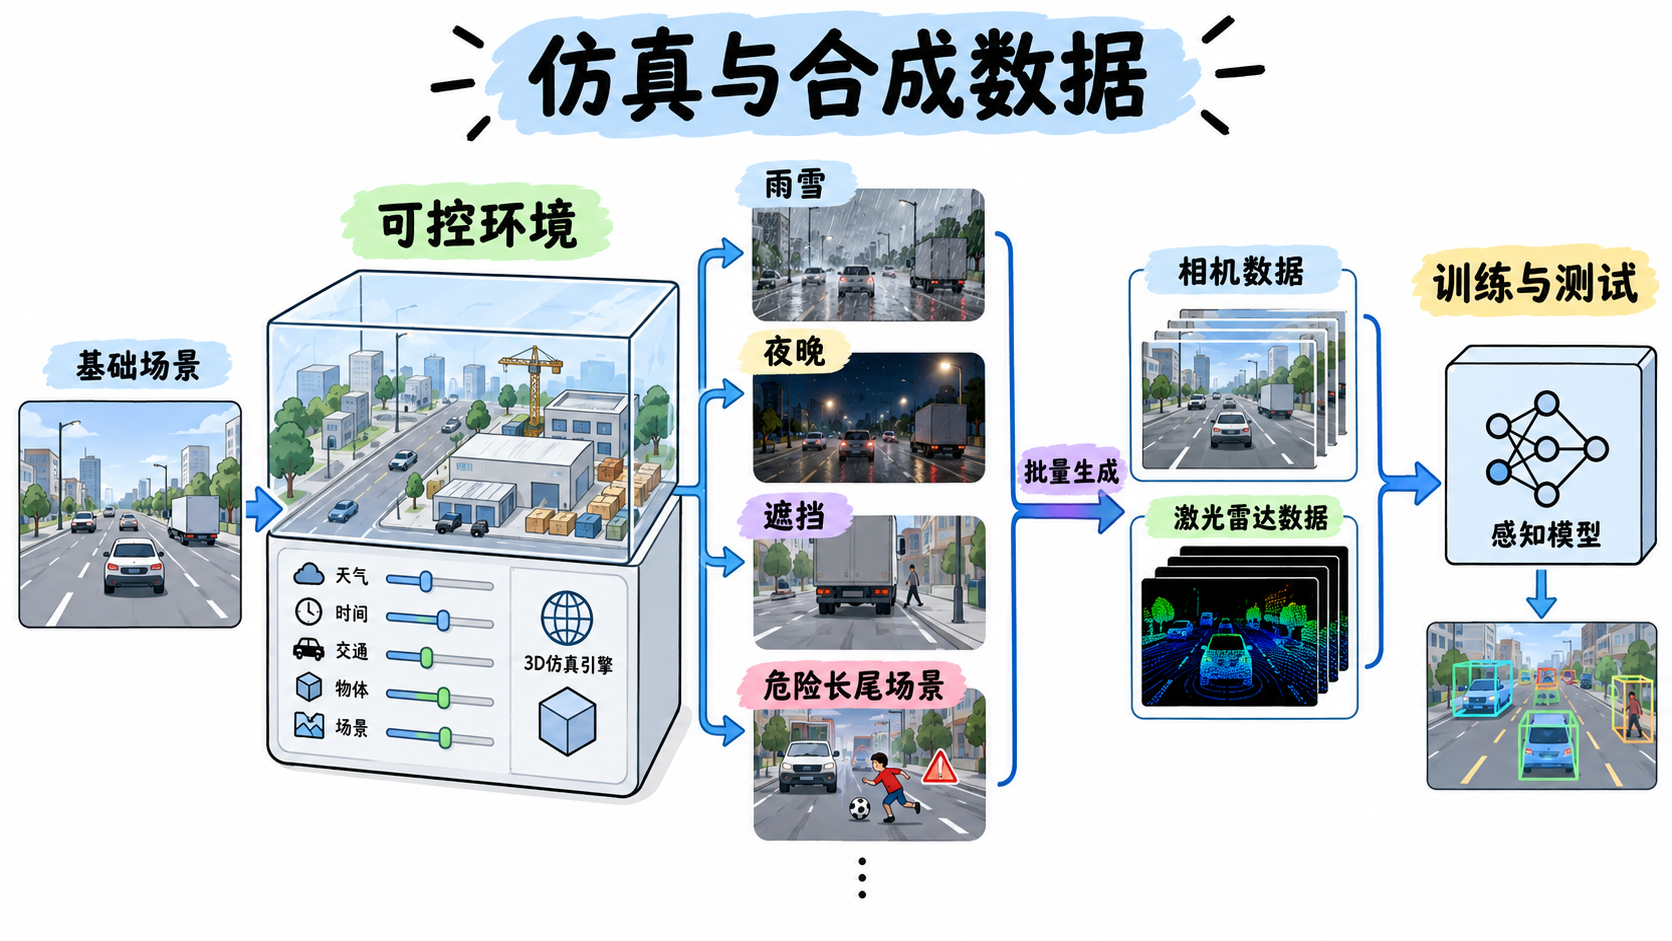
仿真让长尾天气、遮挡和危险情境可以被重复构造与测试。
现实采集昂贵,也难以覆盖所有危险或罕见情境。可控仿真可以重复生成不同天气、道路、光照和遮挡组合,为训练和测试提供补充数据;但合成数据不能自动等同于现实数据。
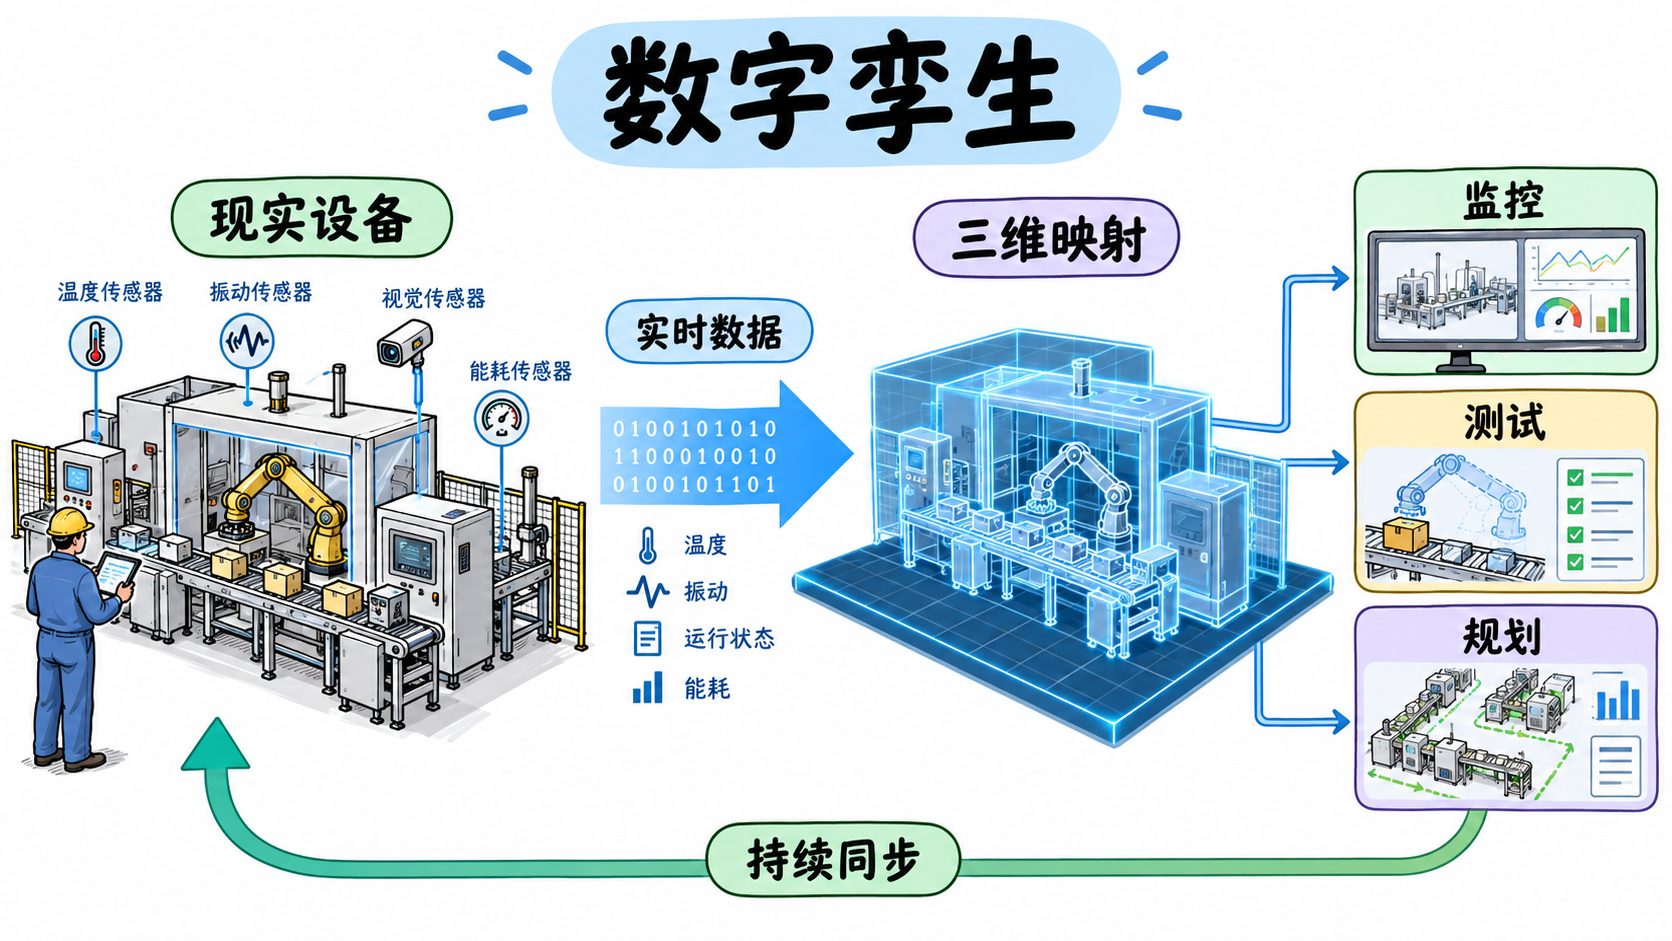
数字孪生把现实状态映射到三维环境,用于监控、测试和规划。
数字孪生的重点是把设备、工厂或城市的真实状态与可操作的模型对应起来。它帮助人们观察和规划,但模型质量、数据延迟和同步误差都需要独立验证。
空间智能最终是一个闭环
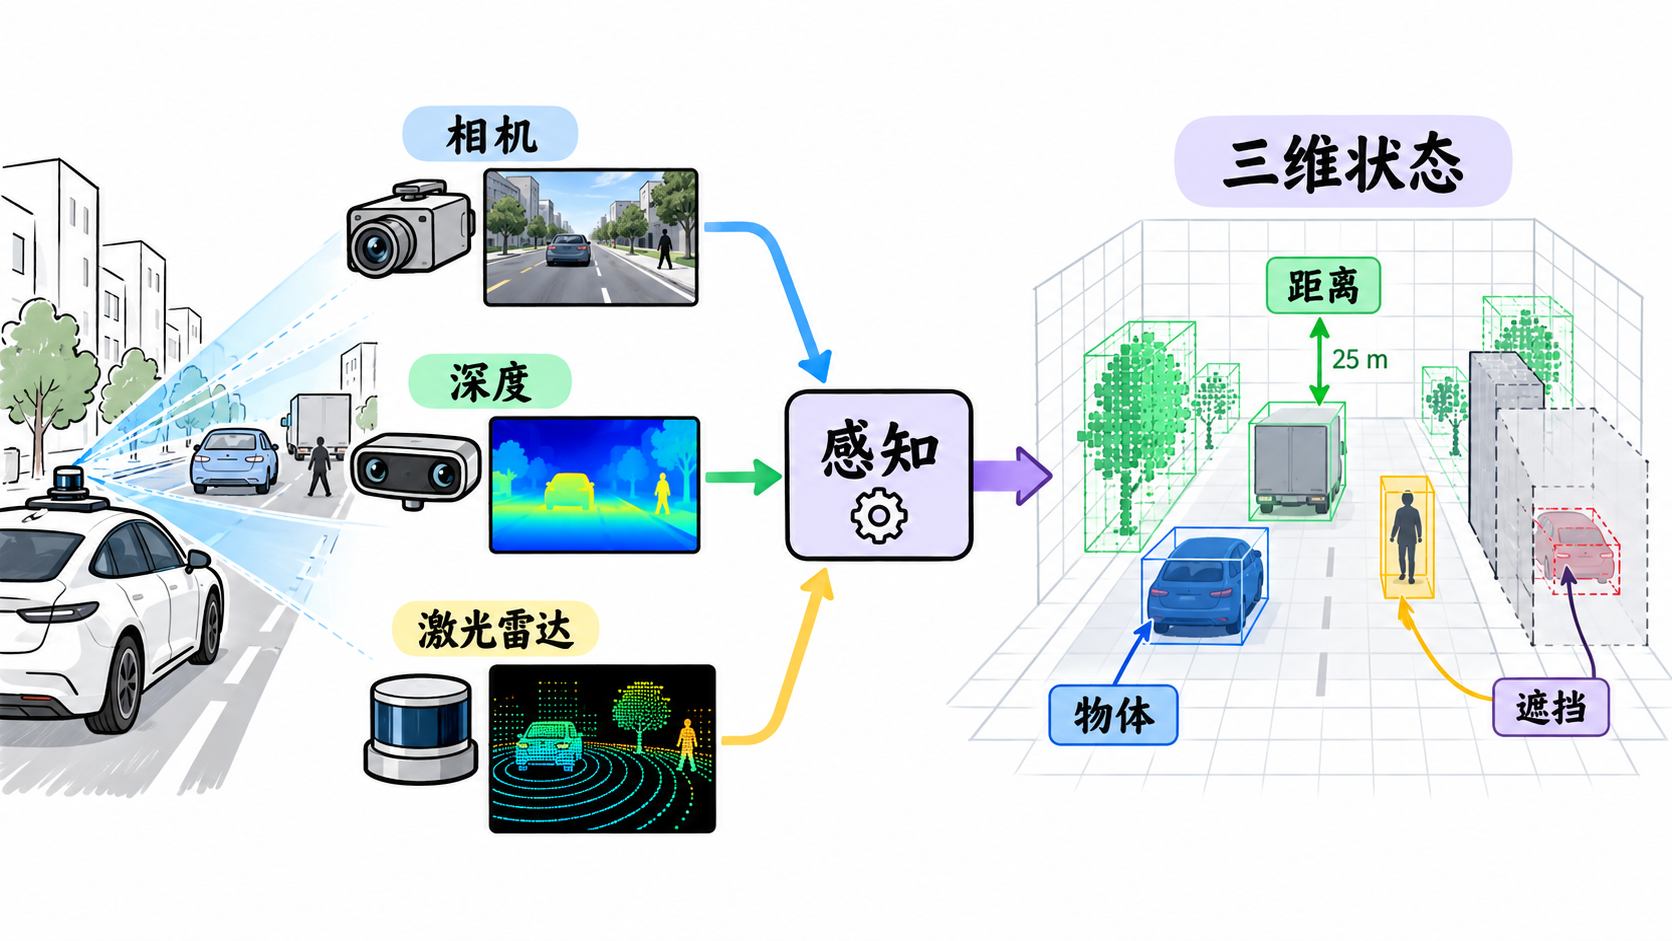
第一步是感知:从传感器数据中建立对环境的空间理解。
理解当前状态后,系统仍需判断变化趋势和可行路径。
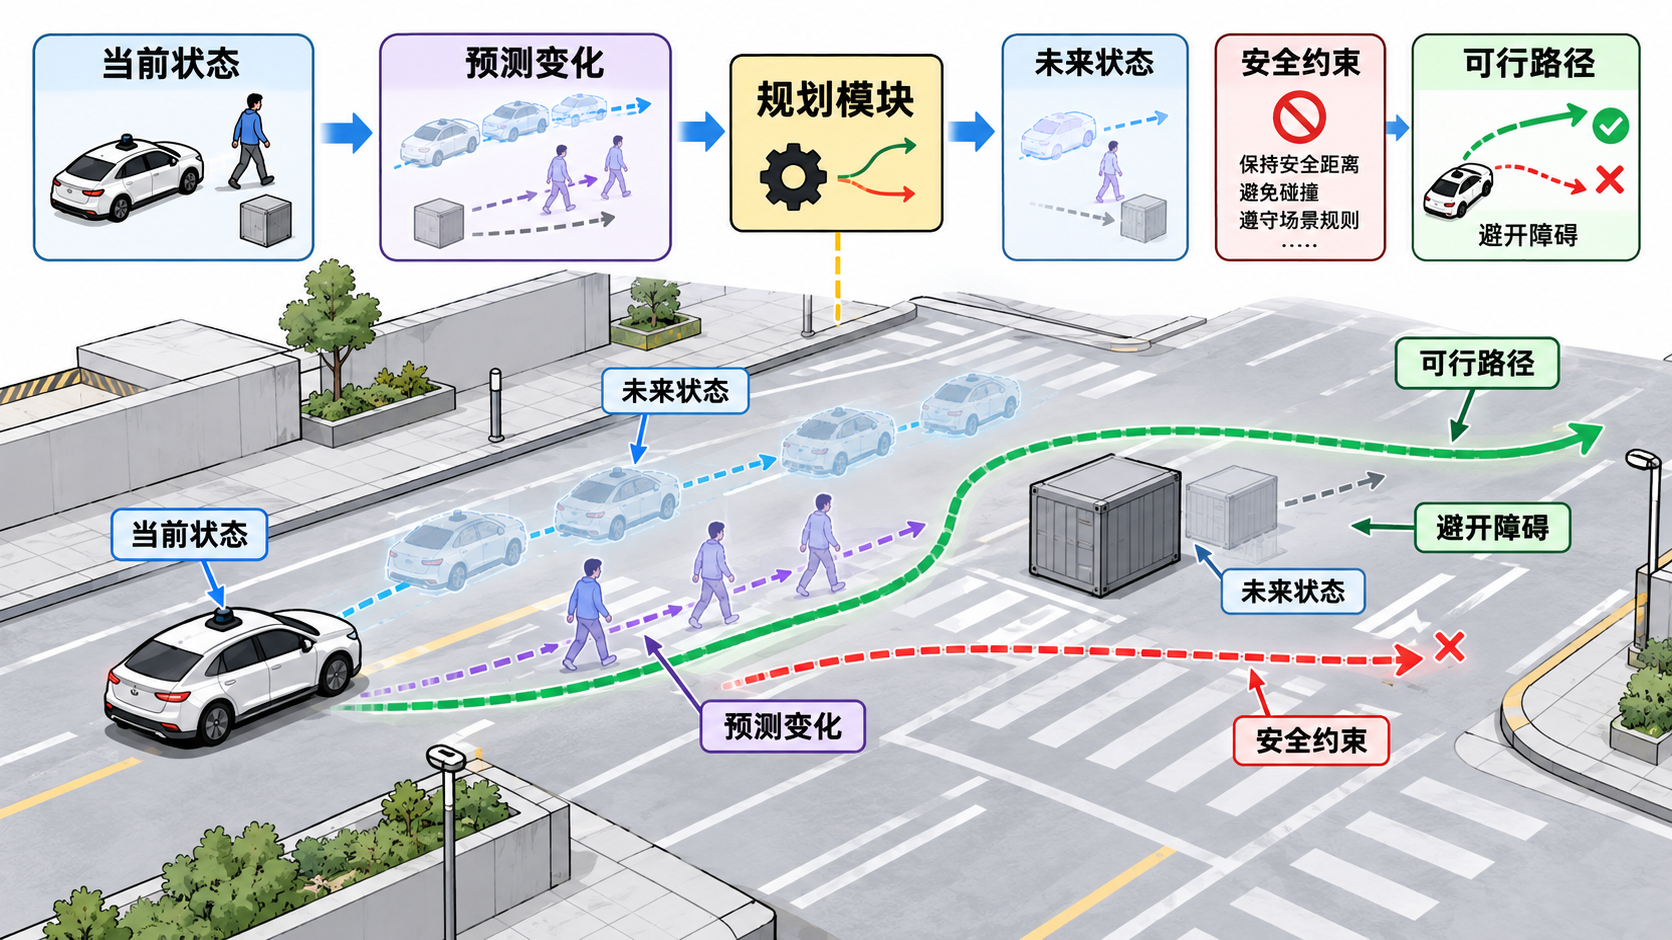
预测和规划把“看见环境”转为“选择下一步行动”。
行动并非结束。执行结果会改变环境,也会成为下一轮判断的输入。
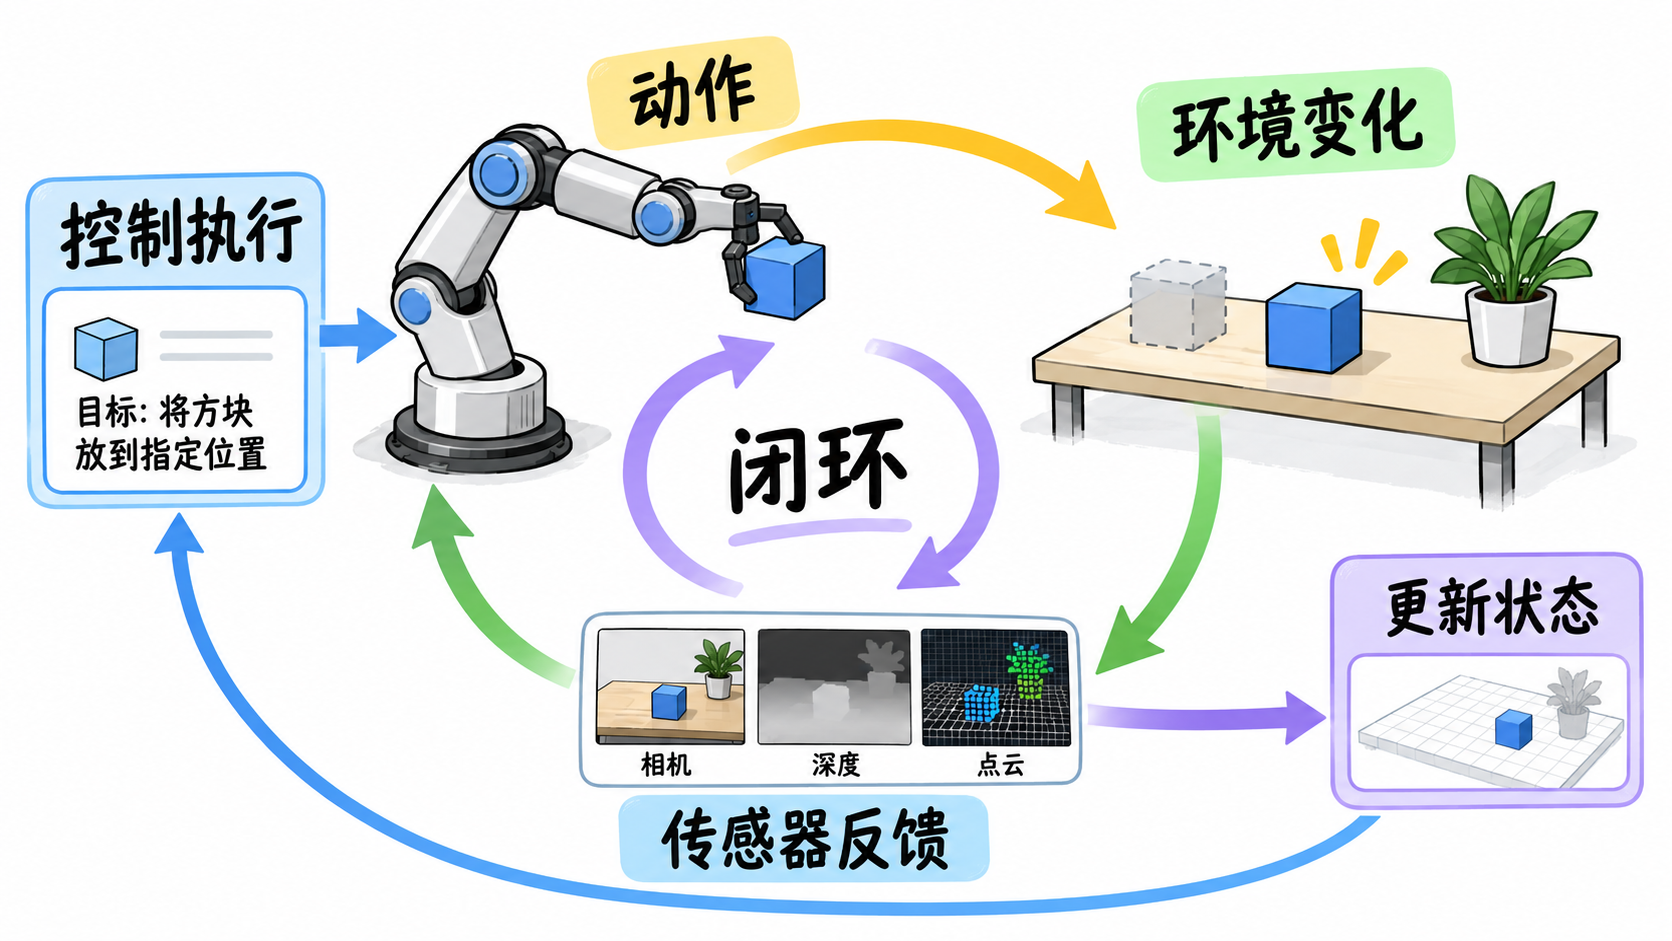
控制和反馈让系统持续校正,而不是一次性做出孤立判断。
结论:逼真的画面不等于可靠的世界模型
空间智能由资产、实时场景、仿真数据和感知—行动闭环共同构成。
视觉逼真并不保证物理真实,也不保证系统会安全行动。跨视角一致性、碰撞动力学、实时性能、现实迁移与实地测试仍是关键边界。面向真实世界的系统,应把专用物理仿真、真实数据、硬件在环和现场测试都纳入验证流程。
参考资料
📌 查阅提示:点击下方超链接可直接复制对应网址,粘贴至手机或电脑浏览器中即可查阅官方完整技术文档与规范。
【官方资料】Blender Features
说明:官方权威技术规范与开发者实现参考手册。【官方资料】Three.js Scene
说明:官方权威技术规范与开发者实现参考手册。【官方资料】CARLA Introduction
说明:官方权威技术规范与开发者实现参考手册。【官方资料】Unity Synthetic Data
说明:官方权威技术规范与开发者实现参考手册。